
新卒インフラエンジニア向け「Kubernetes 実践教科書 ② CKA クラスタ構築・運用編」(全16回)の第3回です。第2回では k8s-cp-01 に単一ノードのクラスタを立て、ノードを Ready にしました。ただし 1 台構成のままだと、その 1 台(正確には API Server)が落ちるとクラスタ全体が操作できなくなります。今回は、複数の Control Plane Node を「1 つの入口」に束ねるためのロードバランサ(HAProxy)を k8s-lb VM に用意し、次回・第4回で本当に 3 台へ増やすための土台を整えます。あわせて、なぜ Control Plane を 3 台にするのか、その根拠となる etcd の quorum(過半数合意)を理解します。
本回で使う VM は 3 台です。プロンプトの # は root、$ は一般ユーザー developer を表し、各 VM へは手元のマシンから developer で SSH ログインし、root が必要な作業は sudo -i で root シェルに切り替えます。
- k8s-lb(
192.168.1.124)― ロードバランサ用の VM。今回ここに HAProxy を構築します。 - alma-proxy(
192.168.1.121)― DNS(dnsmasq)。k8s-lbという名前の指す先を付け替えます。 - k8s-ops(
192.168.1.122)― 第1巻から使っている作業端末。付け替え後に kubectl が通ることの確認をここから行います。
目次
今ここマップ(全 16 回中の現在地)
本シリーズは 6 部構成です。現在地は第1部「クラスタ構築」の第3回です。
- 第1部 クラスタ構築(第1〜5回)← 今ここ
- 第2部 ワークロード管理(第6〜8回)
- 第3部 ネットワーク(第9〜11回)
- 第4部 ストレージ(第12回)
- 第5部 監視・運用(第13〜14回)
- 第6部 トラブルシュート(第15〜16回)
- AlmaLinux 10.2(kernel 6.12.0-211.22.1.el10_2)
- HAProxy 3.0.5(AlmaLinux 標準リポジトリ)
- kubeadm・kubectl v1.35.6
- 確認日 2026-07-11
この回のゴール
本回を終えると、次のことができるようになります。到達できたかは記事末の「やってみよう」と「理解度チェック」で確認します。
- なぜ HA(高可用)が必要か、単一障害点(SPOF)の観点で説明できる
- etcd の quorum(過半数)と「Control Plane は奇数台」の理由を計算できる
- k8s-lb に HAProxy を構築し、API Server(6443)の L4 ロードバランサを用意できる
k8s-lbの名前を HAProxy へ付け替えても、エンドポイント名が不変ならクラスタを作り直さなくてよいと理解する
なぜ HA(高可用)が必要か
第2回で立てた単一ノードクラスタは、Control Plane が 1 台だけです。この 1 台には API Server・etcd・スケジューラ・コントローラマネージャが集中しています。ここが落ちると、新しいデプロイもスケールも自己修復も止まります。これが単一障害点(SPOF:Single Point of Failure)です。
本番では Control Plane を複数台にし、その前段にロードバランサを置いて「1 つの仮想的なエンドポイント」に見せます。利用者や各ノードは常にその 1 つの名前(本シリーズでは k8s-lb:6443)に接続し、ロードバランサが生きている Control Plane へ振り分けます。1 台が落ちても、残りが処理を続けます。
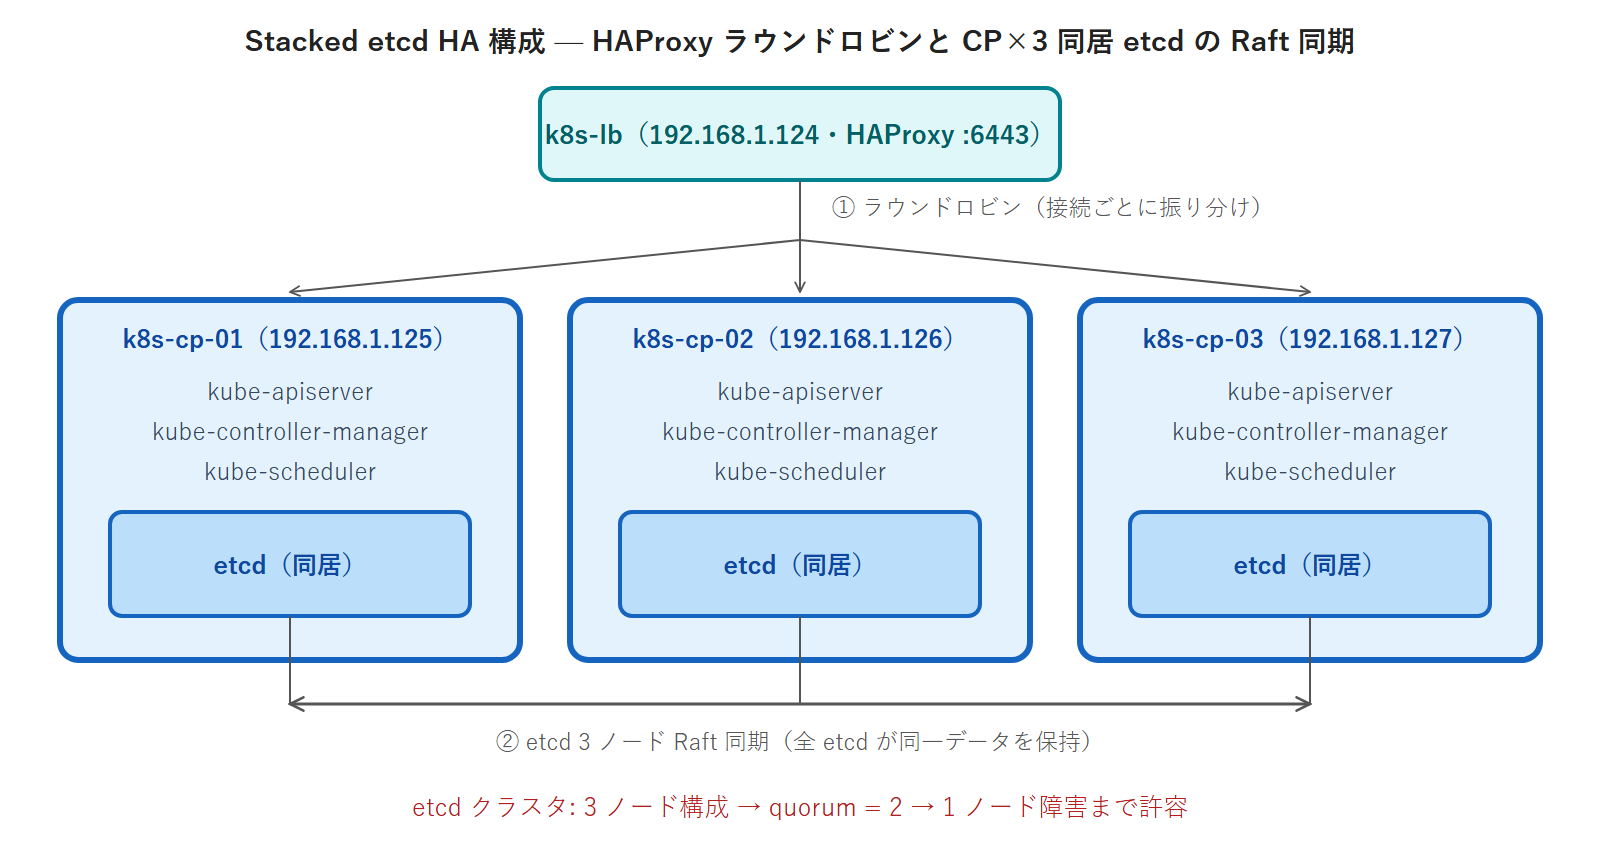
本巻の HA は Stacked etcd 構成を採ります。これは各 Control Plane Node が etcd も同居する方式で、kubeadm の標準です。etcd を別サーバーに分ける External etcd 構成もありますが、本巻では構成をシンプルに保つため stacked を使います。
etcd の quorum を理解する
Control Plane を「何台にするか」を決めるのが etcd の quorum です。etcd は分散データベースで、データの書き込みには過半数(quorum)のノードの合意が必要です(Raft という合意アルゴリズム)。過半数を割ると、データ保護のため書き込みを受け付けなくなります。
台数ごとの quorum と「何台まで落ちても書き込めるか(障害耐性)」を整理します。
| etcd ノード数 | quorum(必要な過半数) | 障害耐性(許容ダウン数) |
|---|---|---|
| 1 | 1 | 0(1 台落ちたら停止) |
| 3 | 2 | 1 |
| 4 | 3 | 1 |
| 5 | 3 | 2 |
ここで注目したいのが、4 台は 3 台と障害耐性が同じ(どちらも 1 台)という点です。台数を 1 つ増やしても耐性は上がらず、コストだけ増えます。しかも偶数は、ネットワークがちょうど半分に分断されたとき、両側とも過半数(quorum)を割ってクラスタ全体が止まってしまいます(奇数なら、多い側が過半数を保って動き続けられます)。だから etcd は 奇数台にするのが定石で、本巻は Control Plane を 3 台にします。第4回で cp-02・cp-03 を追加して 3 台にするのは、この quorum の設計に基づいています。
API Server ロードバランサの設計
次に、Control Plane を束ねるロードバランサを設計します。役割は、k8s-lb:6443 への接続を、生きている Control Plane の 6443 へ振り分けることです。最終的には cp-01〜03 の 3 台を束ねますが、振り分け先(backend)には実際に存在するノードだけを登録します。第3回の時点で存在するのは cp-01 だけなので、まずは cp-01 だけを backend にし、cp-02・cp-03 は第4回で join するときに追加します。
この図は本回で用意する経路そのものを表します。backend には現時点で存在する cp-01 の 1 台だけを登録するので、図・設定・stats のいずれも cp-01 の 1 台で一致します。cp-02・cp-03 は第4回で join するときに backend へ追加し、3 台が揃った HA の全体像もそこで描きます。
設計上の要点は 2 つです。まず、HAProxy は L4(mode tcp)で動かします。API Server の通信は TLS で暗号化されており、その証明書はクラスタ側(API Server とクライアント)で検証します。ロードバランサが中身を復号(TLS 終端)してしまうと証明書検証が壊れるため、HAProxy は中身を見ずに TCP のまま素通しします。次に、option tcp-check で各 Control Plane の 6443 が生きているかを監視し、落ちたノードは自動的に振り分け対象から外します。
k8s-lb に HAProxy を構築する
k8s-lb(192.168.1.124)に root で HAProxy を導入します。AlmaLinux 標準リポジトリからインストールします。
実行コマンド(k8s-lb・root):
# dnf install -y haproxy
# haproxy -v | head -1
実行結果:
HAProxy version 3.0.5-8e879a5 2024/09/19 - https://haproxy.org/次に設定ファイル /etc/haproxy/haproxy.cfg を書きます(cat > でパッケージ同梱の既定設定はまるごと置き換わります)。API Server 用のフロントエンド(6443)とバックエンド(現時点で存在する cp-01 のみ)、stats ページ(9000)、そして第11回で使う Gateway 用(443)を定義します。cp-02・cp-03 は第4回で join するときに backend へ追加します。443 の転送先 Traefik は第11回まで存在しないため、その backend は当面 DOWN で構いません。
実行コマンド(k8s-lb・root):
# cat <<'EOF' > /etc/haproxy/haproxy.cfg
global
  log /dev/log local0
  maxconn 4000

defaults
  log global
  timeout connect 5s
  timeout client  50s
  timeout server  50s

frontend stats
  bind *:9000
  mode http
  stats enable
  stats uri /stats

frontend k8s-api
  bind *:6443
  mode tcp
  default_backend k8s-cp-api

backend k8s-cp-api
  mode tcp
  option tcp-check
  balance roundrobin
  server k8s-cp-01 192.168.1.125:6443 check

frontend gateway-https
  bind *:443
  mode tcp
  default_backend traefik-https

backend traefik-https
  mode tcp
  server traefik 192.168.1.200:443 check
EOF
timeout client・timeout server を 50 秒にしている点にも触れておきます。API Server への接続には、kubelet やコントローラが変更を監視し続ける「watch」など、長時間つなぎっぱなしにする通信が多く含まれます。この値が短すぎると、一時的に無通信になった watch がロードバランサ側で切断され、再接続を繰り返す原因になります。kubeadm 公式の HA 構成例に合わせ、余裕を持たせた 50 秒にしています。
ここで、SELinux の設定を 1 つ加えます。k8s-lb は SELinux が Enforcing で、既定では HAProxy が「HTTP/キャッシュ用の標準ポート以外」へ接続することを許しません。6443 はその範囲外のため、このままでは HAProxy が Control Plane の API Server へ繋げず、backend が DOWN のままになります。haproxy_connect_any という真偽値(boolean)を有効にして、任意のポートへの接続を許可します。
実行コマンド(k8s-lb・root):
# setsebool -P haproxy_connect_any 1
# getsebool haproxy_connect_any
実行結果:
haproxy_connect_any --> onfirewalld で必要なポートを開けます。API Server LB の 6443、stats の 9000、そして第11回の HTTPS 公開で使う 443・80 を開放します。
実行コマンド(k8s-lb・root):
# firewall-cmd --permanent --add-port=6443/tcp
# firewall-cmd --permanent --add-port=9000/tcp
# firewall-cmd --permanent --add-port=443/tcp
# firewall-cmd --permanent --add-port=80/tcp
# firewall-cmd --reload
# firewall-cmd --list-ports
実行結果:
80/tcp 443/tcp 6443/tcp 9000/tcpHAProxy を起動し、自動起動を有効にします。
実行コマンド(k8s-lb・root):
# systemctl enable --now haproxy
# systemctl is-active haproxy
実行結果:
activek8s-lb の名前を HAProxy へ付け替える
第2回では、k8s-lb という名前を暫定的に k8s-cp-01(192.168.1.125)へ向けていました。HAProxy が動き出した今、この名前の指す先を、本来の k8s-lb VM(192.168.1.124)へ付け替えます。名前解決は alma-proxy の dnsmasq が担っており、全 VM の対応表 /etc/dnsmasq.hosts の k8s-lb 行を書き換えます。
実行コマンド(alma-proxy・root):
# sed -i 's/^192.168.1.125 k8s-lb/192.168.1.124 k8s-lb/' /etc/dnsmasq.hosts
# systemctl restart dnsmasq
dnsmasq は設定の再読み込み(reload)に対応していないため、反映には restart を使います。k8s-ops から名前が k8s-lb VM(.124)を指すようになったこと、そして kubectl が引き続き通ることを確認します。なお kubectl は第2回で用意した kubeadm 用の kubeconfig を使います。KUBECONFIG はセッションごとの設定なので、別のセッションで作業している場合は、先に export KUBECONFIG=~/.kube/kubeadm.conf を実行してから確認してください(設定していないと第1巻の kind クラスタを指したままになります)。
実行コマンド(k8s-ops・developer):
$ getent hosts k8s-lb
$ kubectl get nodes
実行結果:
192.168.1.124    k8s-lb
NAME        STATUS   ROLES           AGE   VERSION
k8s-cp-01   Ready    control-plane   13h   v1.35.6
ここが今回の設計の肝です。kubectl の接続先も、cp-01 の証明書に記載された名前も、admin.conf の server 値も、すべて k8s-lb:6443 のままです。名前が指す IP は .125 から .124 へ変わりましたが、名前そのものは変わっていないため、クラスタを作り直す必要はありません。この「名前で間接的に指す」設計により、今後 HAProxy の背後で Control Plane を増やしても、クライアント側は何も変えずに済みます。今の経路は、kubectl → k8s-lb:6443(HAProxy・.124)→ cp-01(.125):6443 です。
HAProxy stats で疎通を確認する
HAProxy の stats ページで、振り分け先の状態を目で確認します。手元のマシンのブラウザから http://192.168.1.124:9000/stats を開きます(あるいは k8s-lb で curl しても確認できます)。
実行コマンド(k8s-lb・root):
# curl -s 'http://127.0.0.1:9000/stats;csv' | awk -F, '$1=="k8s-cp-api"{print $2, $18}'実行結果:
k8s-cp-01 UP
BACKEND UP
k8s-cp-api バックエンドには cp-01 だけを登録したので、その cp-01 が UP と表示されます。最終行の BACKEND UP は集約行で、バックエンドに生きたサーバ(cp-01)があり振り分け可能、という意味です。存在するノードだけを登録しているので、DOWN の行は出ません。
補足として、いまの etcd クラスタは cp-01 の 1 台だけ、つまり 1 ノードクラスタで、その quorum は 1 です。cp-01 が生きている限り quorum を満たしており正常に動いています。第4回で cp-02・cp-03 を join し、あわせて HAProxy の backend にも追加すると、stats に 3 台が UP で並び、そこで初めて「3 台で 1 台の障害に耐える」HA が成立します。
なお、traefik-https バックエンド(第11回の Gateway 用に先に定義したもの)は、Traefik を導入するまで DOWN のままで問題ありません。こちらは登録先が確定しているため、あえて先に書いています。
1 点、運用上の注意です。この stats ページには認証を設けていないため、9000 番を開放したネットワークからは誰でも閲覧でき、バックエンドの IP や稼働状況が見えてしまいます。本シリーズでは確認の手軽さを優先してこの構成にしていますが、本番では stats を内部ネットワーク限定にする(bind を管理用アドレスに絞る、または firewalld で 9000 をアクセス元制限する)、あるいは stats auth で認証を付けるのが定石です。
やってみよう
quorum を計算する
次の 3 つに、紙の上で答えてください。(1) Control Plane が 3 台のとき、何台まで落ちても書き込みを続けられるか。(2) 5 台ならどうか。(3) なぜ 4 台にしないのか。答え合わせは本文「etcd の quorum を理解する」の表で行えます。
stats で振り分け先の状態を読む
手元のマシンのブラウザで http://192.168.1.124:9000/stats を開き、k8s-cp-api バックエンドに cp-01 が 1 台だけ登録され、UP になっていることを確認してください。第4回で cp-02・cp-03 を join・登録すると、この一覧が 3 台に増えます。
名前の付け替えを確かめる
kubectl は kubeadm 用の kubeconfig を使います。別のセッションで実行する場合は、先に export KUBECONFIG=~/.kube/kubeadm.conf を実行してください(設定していないと第1巻の kind クラスタを指したままになります)。
実行コマンド(k8s-ops・developer):
$ getent hosts k8s-lb
$ kubectl cluster-info | head -1
k8s-lb が .124(HAProxy)を指すようになり、それでもクラスタのエンドポイントが k8s-lb:6443 のまま変わっていないことを確認してください。エンドポイント名が不変であることが、クラスタを作り直さずに済んでいる理由です。
まとめ
本回では、HA の必要性(SPOF の排除)と、その台数を決める etcd の quorum を学び、k8s-lb に API Server 用の L4 ロードバランサ(HAProxy)を構築しました。backend には存在する cp-01 だけを登録し、そして k8s-lb の名前を HAProxy へ付け替え、エンドポイント名を変えずに経路だけを差し替えました。stats では登録した cp-01 が UP ― 3 台に増やす舞台が整った状態です。
理解度チェック(○×形式・全 7 問)
次の各文が正しいか(○)誤りか(×)を判断してください。下の「解答と解説」を開くと答え合わせができます。
- Control Plane が 1 台だけの構成には単一障害点(SPOF)がある。
- etcd は偶数台にするのが推奨である。
- Control Plane が 3 台なら、1 台が落ちても書き込みを続けられる。
- HAProxy は API Server の TLS を終端(復号)してから振り分ける。
k8s-lbの指す IP を .125 から .124 へ変えたら、クラスタを作り直す必要がある。- SELinux が Enforcing のとき、
haproxy_connect_anyを有効にしないと HAProxy は 6443 の backend へ繋げないことがある。 - 第3回では HAProxy の backend に cp-01 の 1 台だけを登録し、cp-02・cp-03 は第4回で join するときに追加する。
解答と解説
1=○/2=×(奇数台が定石。4 台は 3 台と障害耐性が同じ)/3=○(quorum 2 を維持できる)/4=×(mode tcp で終端せず素通しする)/5=×(エンドポイント名が不変なら再構築不要)/6=○(off のままだと backend が DOWN になる)/7=○(存在するノードだけを登録する。cp-02・cp-03 は第4回で join 時に追加)
次回予告
次回・第4回では、いよいよ cp-02・cp-03 を kubeadm join --control-plane で参加させ、Workload Node(k8s-wl-01・02)も加えて 5 ノードの HA クラスタを完成させます。あわせて、join した cp-02・cp-03 を HAProxy の backend に追加し、stats に 3 台が UP で並ぶことを確認します。さらに、第1巻で作った fanclub-api をこの本番クラスタへ移行します。
