
新卒インフラエンジニア向け「Kubernetes 実践教科書 ② CKA クラスタ構築・運用編」(全16回)の第6回です。第1部では HA クラスタを構築し、etcd のバックアップ・リストアやノードの入れ替えも扱いました。ここからの第2部「ワークロード管理」では、クラスタを作って終わりにせず、育て続ける運用に踏み込みます。その第一歩が本回のテーマ、kubeadm によるクラスタのアップグレードです。Kubernetes は年に数回のマイナーリリースがあり、本番クラスタは計画的にバージョンを上げ続けなければなりません。今回は、ワークロードを止めずに 1 ノードずつ入れ替える「ローリングアップグレード」の正しい順序と、あわせて証明書の更新、そしてアップグレード後の軽いトラブルシュートまでを実機で通します。いずれも CKA で頻出の実技です。
本回で使う VM は 5 ノードすべてと作業端末です。プロンプトの # は root、$ は一般ユーザー developer を表し、各 VM へは手元のマシンから developer で SSH ログインし、root が必要な作業は sudo -i で root シェルに切り替えます。各コマンドの前に実行先のホスト名を明記します。
- k8s-cp-01〜03(
192.168.1.125〜127)― Control Plane Node。アップグレードは cp-01 から順に行います。 - k8s-wl-01・02(
192.168.1.128・129)― Workload Node。Control Plane の後にアップグレードします。 - k8s-ops(
192.168.1.122)― 作業端末。kubectl(drain / uncordon / get nodes)はここから実行します。
目次
今ここマップ(全 16 回中の現在地)
本シリーズは 6 部構成です。現在地は第2部「ワークロード管理」の第6回です。
- 第1部 クラスタ構築(第1〜5回)
- 第2部 ワークロード管理(第6〜8回)← 今ここ
- 第3部 ネットワーク(第9〜11回)
- 第4部 ストレージ(第12回)
- 第5部 監視・運用(第13〜14回)
- 第6部 トラブルシュート(第15〜16回)
- AlmaLinux 10.2(kernel 6.12.0-211.22.1.el10_2)
- アップグレード元 kubeadm・kubelet・kubectl v1.35.6 → アップグレード先 v1.36.2
- CoreDNS v1.13.1 → v1.14.2
- etcd 3.6.6 → 3.6.8
- containerd.io v2.2.6
- 確認日 2026-07-12
本巻はここまで v1.35 でクラスタを構築してきました。本回のアップグレードで、ラボは v1.36 に上がります。以降の回は v1.36 のクラスタで進めます。なお CKA 試験は本稿執筆時点で v1.35 ですが、アップグレードの手順自体はマイナー番号が変わっても同じです。「1 つ先のマイナーへ上げる」体験として読んでください。
この回のゴール
本回を終えると、次のことができるようになります。到達できたかは記事末の「やってみよう」と「理解度チェック」で確認します。
kubeadm upgrade planでアップグレード可能なバージョンを確認できる- Control Plane → Workload Node の正しい順序でローリングアップグレードできる(1 台目の cp は
apply、それ以外はupgrade node) dnf versionlockでパッケージのバージョンを固定・解除できるkubeadm certs check-expiration/renewで証明書の期限を確認・更新できる- アップグレード後の軽い不具合(Pending Pod)を
describeの Events から診断できる
アップグレードの鉄則(バージョンスキューと順序)
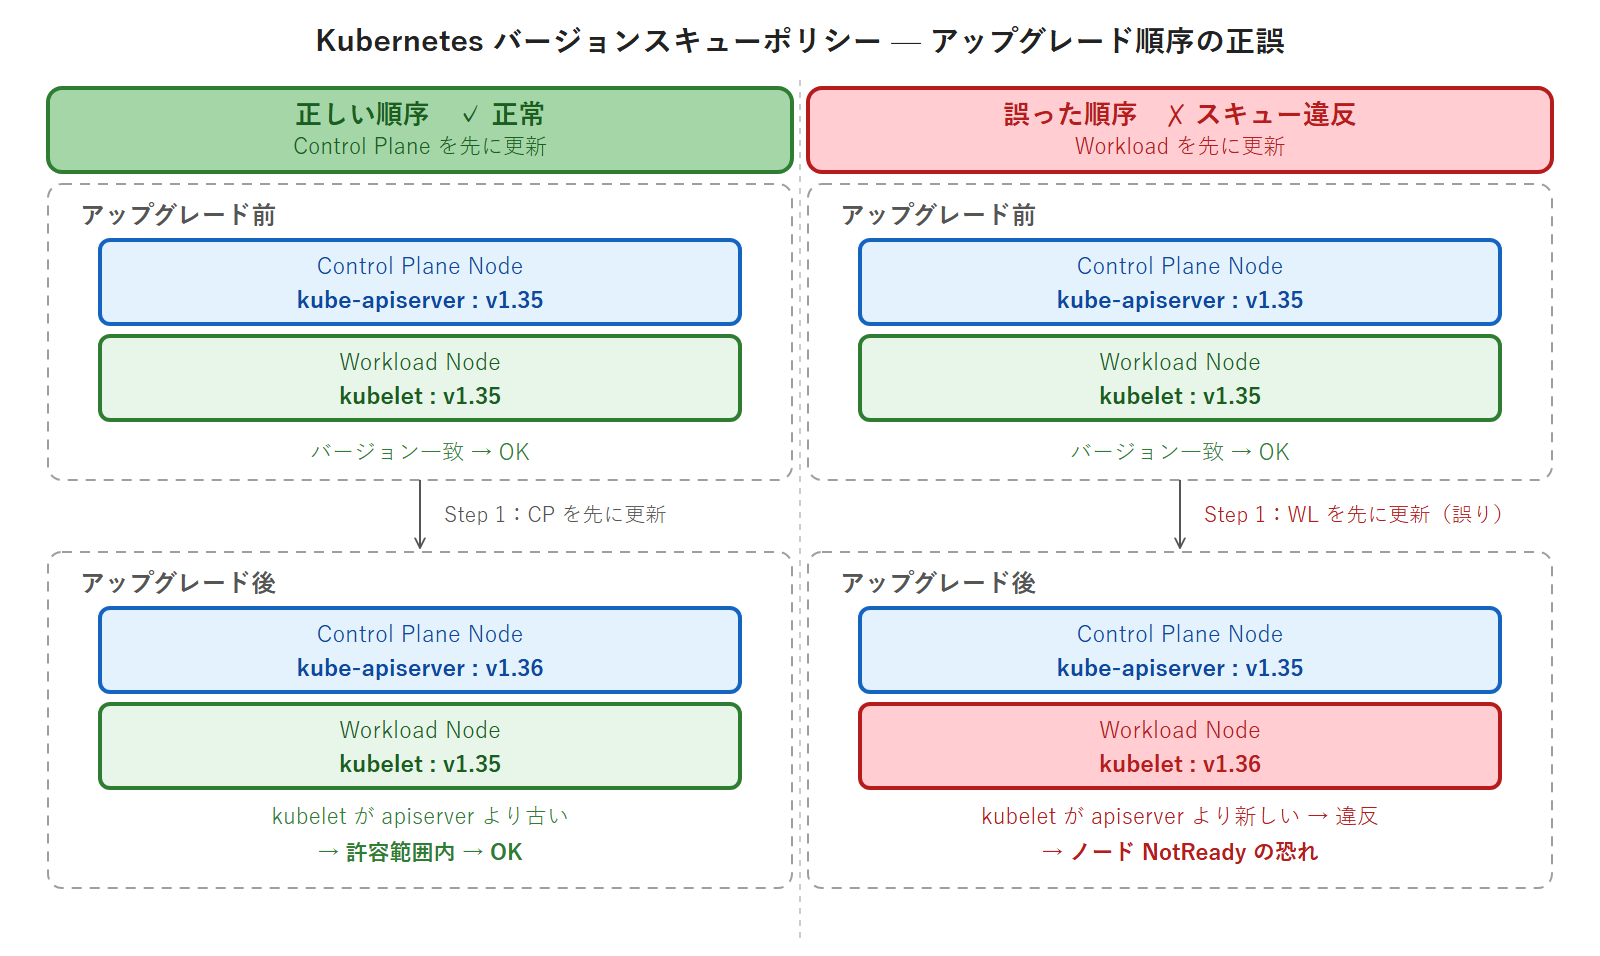
手を動かす前に、なぜ順序が決まっているのかを押さえます。Kubernetes にはバージョンスキューポリシーという「各コンポーネントのバージョンがどこまで離れてよいか」の規則があります。要点は 2 つです。
- kubelet は kube-apiserver より新しくてはいけない(古い方向には 3 マイナーまで許容)。つまり kubelet ≤ apiserver。
- kubectl は apiserver の ±1 マイナー以内。
この規則から、アップグレードの順序が導かれます。先に Workload Node(kubelet)を上げてしまうと、まだ古い apiserver よりも kubelet が新しくなり、スキュー違反でクラスタが不安定になります。したがって必ず Control Plane(apiserver 側)を先に上げ、Workload Node(kubelet 側)を後に上げます。本回の順序は次のとおりです。
- 1 台目の Control Plane(cp-01)を
kubeadm upgrade applyで上げる(control-plane コンポーネント + etcd + CoreDNS/kube-proxy の設計を更新) - 残りの Control Plane(cp-02・cp-03)を
kubeadm upgrade nodeで上げる - 各 Workload Node(wl-01・wl-02)を
kubeadm upgrade nodeで上げる
そして各ノードとも、kubeadm 本体を入れ替えた後にそのノードの kubelet / kubectl も同じバージョンへ入れ替えます。ノードを 1 台ずつ処理し、その間ワークロードは他のノードで動き続けるため、全体としては無停止でアップグレードできます。
アップグレード可能バージョンを調べる(cp-01)
まず 1 台目の Control Plane、cp-01 で作業します。その前に、cp-01 だけに必要な下ごしらえが 1 つあります。kubeadm upgrade(plan も apply も)は、クラスタの API Server エンドポイント k8s-lb:6443 へ接続して健全性を確認します。ところが cp-01 は第2回で構築した際、シェルの no_proxy(/etc/profile.d/proxy.sh)に k8s-lb というホスト名を加えていませんでした(第2回の kubeadm init は localhost 相手で不要だったためです)。このまま sudo -i の root シェル(/etc/profile.d/proxy.sh が読み込まれ、プロキシ環境変数が効いた状態)で kubeadm upgrade を実行すると、k8s-lb:6443 への接続がプロキシ経由になり Forbidden で弾かれます。第4回で追加した他ノードに合わせ、cp-01 の no_proxy にもノード名を追加します。
実行コマンド(k8s-cp-01・root):
# grep -q ',k8s-lb' /etc/profile.d/proxy.sh || sed -i 's/\.cluster\.local"/.cluster.local,k8s-lb,k8s-cp-01,k8s-cp-02,k8s-cp-03,k8s-wl-01,k8s-wl-02,alma-proxy,k8s-registry"/' /etc/profile.d/proxy.sh
# source /etc/profile.d/proxy.sh
no_proxy はログイン時に読み込まれるため、今の root シェルへ反映するには source /etc/profile.d/proxy.sh を実行するか、いったん exit して sudo -i で入り直します。次に、本巻ではパッケージを dnf versionlock で v1.35.6 に固定してきたので、アップグレードのためにまず kubeadm の固定を解除します。
実行コマンド(k8s-cp-01・root):
# dnf versionlock delete kubeadm次がマイナーアップグレード固有の重要な一手です。本巻のパッケージリポジトリは v1.35 系だけを指しています。v1.36 のパッケージを取得するには、リポジトリ定義 /etc/yum.repos.d/kubernetes.repo の URL を v1.35 から v1.36 へ張り替えます(パッチ間のアップグレードなら不要ですが、マイナーをまたぐときは必須です)。
実行コマンド(k8s-cp-01・root):
# sed -i 's#/core:/stable:/v1.35/#/core:/stable:/v1.36/#g' /etc/yum.repos.d/kubernetes.repo
# grep -E 'baseurl|gpgkey' /etc/yum.repos.d/kubernetes.repo
実行結果:
baseurl=https://pkgs.k8s.io/core:/stable:/v1.36/rpm/
gpgkey=https://pkgs.k8s.io/core:/stable:/v1.36/rpm/repodata/repomd.xml.key
張り替えたリポジトリから、アップグレード先の kubeadm(v1.36.2)を導入します。導入後、kubeadm upgrade plan でクラスタ全体のアップグレード計画を確認します。
実行コマンド(k8s-cp-01・root):
# dnf install -y kubeadm-1.36.2-150500.2.1
# kubeadm version -o short
# kubeadm upgrade plan
実行結果(抜粋):
v1.36.2

[upgrade/versions] Cluster version: 1.35.6
[upgrade/versions] kubeadm version: v1.36.2
[upgrade/versions] Target version: v1.36.2
[upgrade/versions] Latest version in the v1.35 series: v1.35.6

Components that must be upgraded manually after you have upgraded the control plane with 'kubeadm upgrade apply':
COMPONENT   NODE        CURRENT   TARGET
kubelet     k8s-cp-01   v1.35.6   v1.36.2
kubelet     k8s-cp-02   v1.35.6   v1.36.2
kubelet     k8s-cp-03   v1.35.6   v1.36.2
kubelet     k8s-wl-01   v1.35.6   v1.36.2
kubelet     k8s-wl-02   v1.35.6   v1.36.2

Upgrade to the latest stable version:

COMPONENT                 NODE        CURRENT   TARGET
kube-apiserver            k8s-cp-01   v1.35.6   v1.36.2
kube-controller-manager   k8s-cp-01   v1.35.6   v1.36.2
kube-scheduler            k8s-cp-01   v1.35.6   v1.36.2
kube-proxy                            1.35.6    v1.36.2
CoreDNS                               v1.13.1   v1.14.2
etcd                      k8s-cp-01   3.6.6-0   3.6.8-0

You can now apply the upgrade by executing the following command:

	kubeadm upgrade apply v1.36.2
plan が示すバージョンは実行時点の最新パッチになります。上の出力は本書の検証時点のもので、実際には Target version が v1.36.3 のように、より新しいパッチ版で表示されることがあります(あわせて Latest version in the v1.35 series も v1.35.7 などに変わります)。その場合、末尾の案内も kubeadm upgrade apply v1.36.3、さらに Note: Before you can perform this upgrade, you have to update kubeadm to v1.36.3. と表示されます。これは「最新へ上げよ」という提案にすぎません。本書は再現性を優先してバージョンを固定する方針なので、この提案には従わず、次節で v1.36.2 を明示して apply します。導入済みの kubeadm が v1.36.2 であれば v1.36.2 への apply は問題なく実行できます。本番でも「どのパッチ版へ上げるか」は計画して決めるものであり、plan の提案を鵜呑みにしないのが定石です。
plan は「クラスタは今 1.35.6、これから 1.36 系へ上げられる」ことを示します。注目したいのは 2 つの表です。上の表は「apply の後に手動で上げる必要があるもの」=各ノードの kubelet で、5 ノードすべてが対象です。下の表は apply が自動で面倒を見るもの(apiserver・controller-manager・scheduler・kube-proxy・CoreDNS・etcd)です。つまり kubeadm upgrade apply はコントロールプレーンの中身と etcd までは上げてくれますが、kubelet は各ノードで自分で上げる必要がある、という役割分担が読み取れます。
最初の Control Plane をアップグレードする(cp-01)
計画を確認したので、cp-01 で kubeadm upgrade apply を実行します。1 台目の Control Plane だけがこの apply を使います(2 台目以降と Workload Node は後述の upgrade node)。apply は新しいコンポーネントのイメージを取得し、Static Pod の manifest を書き換え、etcd の証明書も更新します。数分かかります。
実行コマンド(k8s-cp-01・root):
# kubeadm upgrade apply v1.36.2 --yes実行結果(末尾):
[upgrade/addon] Skipping upgrade of addons because control plane instances [k8s-cp-02 k8s-cp-03] have not been upgraded

[upgrade] SUCCESS! A control plane node of your cluster was upgraded to "v1.36.2".

[upgrade] Now please proceed with upgrading the rest of the nodes by following the right order.
SUCCESS! が出ました。cp-01 のコントロールプレーン(apiserver 等)と etcd は v1.36.2 になりました。末尾で CoreDNS/kube-proxy の addon 更新が「他の Control Plane がまだ上がっていないのでスキップ」と出ているのは正常です。addon は最後の Control Plane を上げたときにまとめて反映されます。続いて、この cp-01 の kubelet と kubectl を上げます。まずノードを drain して安全にしてから作業します。drain は k8s-ops から実行します。
実行コマンド(k8s-ops・developer):
$ kubectl drain k8s-cp-01 --ignore-daemonsets実行結果:
node/k8s-cp-01 cordoned
Warning: ignoring DaemonSet-managed Pods: kube-system/calico-node-kp2tv, kube-system/kube-proxy-zk6fh
node/k8s-cp-01 drained
Control Plane Node には第2回で付けた taint があり通常の Pod は載っていないため、drain では DaemonSet(calico-node・kube-proxy)を除いて退避するものはほぼありません。ただし CoreDNS や calico-kube-controllers は control-plane の taint を許容する設定になっているため、それらが cp-01 に載っていた場合は evicting pod ... として退避されます(正常な動作です)。次に cp-01 に戻り、kubelet / kubectl を v1.36.2 へ入れ替えます。固定を解除 → 導入 → kubelet 再起動 → 再固定、という流れです。
実行コマンド(k8s-cp-01・root):
# dnf versionlock delete kubelet kubectl
# dnf install -y kubelet-1.36.2-150500.2.1 kubectl-1.36.2-150500.2.1
# systemctl daemon-reload
# systemctl restart kubelet
# dnf versionlock add kubeadm kubelet kubectl
# kubelet --version
実行結果:
Kubernetes v1.36.2kubelet が新バージョンになったら、k8s-ops から uncordon してノードを再びスケジュール可能に戻します。
実行コマンド(k8s-ops・developer):
$ kubectl uncordon k8s-cp-01
$ kubectl get nodes
実行結果:
node/k8s-cp-01 uncordoned
NAME        STATUS   ROLES           AGE     VERSION
k8s-cp-01   Ready    control-plane   29m     v1.36.2
k8s-cp-02   Ready    control-plane   4h48m   v1.35.6
k8s-cp-03   Ready    control-plane   4h48m   v1.35.6
k8s-wl-01   Ready    <none>          4h47m   v1.35.6
k8s-wl-02   Ready    <none>          4h47m   v1.35.6
cp-01 だけが v1.36.2 になり、残りはまだ v1.35.6 です。この「バージョンが混在した状態」でもクラスタは正常に動きます。バージョンスキューポリシーが 1 マイナーの差を許容しているからです。慌てず 1 台ずつ進めます。
残りの Control Plane をアップグレードする(cp-02 / cp-03)
2 台目以降の Control Plane は、apply ではなく kubeadm upgrade node を使います。ここが間違えやすいポイントです。apply はクラスタ全体の目標バージョンを決める「1 回だけ」の操作で、upgrade node は各ノードを目標バージョンに合わせる操作です。cp-02 で作業します。kubeadm の固定解除・リポジトリ張り替え・kubeadm 導入までは cp-01 と同じです。
実行コマンド(k8s-cp-02・root):
# dnf versionlock delete kubeadm
# sed -i 's#/core:/stable:/v1.35/#/core:/stable:/v1.36/#g' /etc/yum.repos.d/kubernetes.repo
# dnf install -y kubeadm-1.36.2-150500.2.1
# kubeadm upgrade node
実行結果(抜粋):
[upgrade/kubelet-config] The kubelet configuration for this node was successfully upgraded!
[upgrade/addon] Skipping upgrade of addons because control plane instances [k8s-cp-03] have not been upgraded
続いて cp-02 を drain し(k8s-ops から)、kubelet / kubectl を入れ替え、uncordon します。cp-01 と同じ流れです。
実行コマンド(k8s-ops・developer → k8s-cp-02・root → k8s-ops・developer):
$ kubectl drain k8s-cp-02 --ignore-daemonsets
# dnf versionlock delete kubelet kubectl
# dnf install -y kubelet-1.36.2-150500.2.1 kubectl-1.36.2-150500.2.1
# systemctl daemon-reload && systemctl restart kubelet
# dnf versionlock add kubeadm kubelet kubectl
$ kubectl uncordon k8s-cp-02
cp-03 でもまったく同じ手順を繰り返します(versionlock 解除 → repo 張り替え → kubeadm 導入 → kubeadm upgrade node → drain → kubelet/kubectl 入れ替え → uncordon)。3 台目=最後の Control Plane を upgrade node したときに、保留されていた addon(CoreDNS・kube-proxy)の更新がまとめて反映されます。
実行結果(cp-03 の kubeadm upgrade node 末尾・addon が反映される):
[addons] Applied essential addon: CoreDNS
[addons] Applied essential addon: kube-proxy
3 台の Control Plane がすべて v1.36.2 になりました。
Workload Node をアップグレードする(wl-01 / wl-02)
最後に Workload Node です。手順は 2 台目以降の Control Plane と同じ kubeadm upgrade node ですが、こちらは実際にワークロードが載っているため、drain でアプリを他ノードへ退避させる意味が大きくなります。1 台ずつ行い、fanclub-api が動き続けることを確認します。wl-01 から始めます。
実行コマンド(k8s-wl-01・root):
# dnf versionlock delete kubeadm
# sed -i 's#/core:/stable:/v1.35/#/core:/stable:/v1.36/#g' /etc/yum.repos.d/kubernetes.repo
# dnf install -y kubeadm-1.36.2-150500.2.1
# kubeadm upgrade node
実行結果(抜粋・Workload Node では addon をスキップ):
[upgrade/addon] Skipping the addon/coredns phase. Not a control plane node.
[upgrade/addon] Skipping the addon/kube-proxy phase. Not a control plane node.
次に wl-01 を drain します。今度は fanclub-api の Pod(frontend・backend 等)が退避対象になります。--delete-emptydir-data は emptyDir を使う Pod の退避を許可するオプションです。
実行コマンド(k8s-ops・developer):
$ kubectl drain k8s-wl-01 --ignore-daemonsets --delete-emptydir-data退避された Pod はもう一方の wl-02 で起動し直します。続いて wl-01 で kubelet / kubectl を入れ替え、uncordon します。
実行コマンド(k8s-wl-01・root → k8s-ops・developer):
# dnf versionlock delete kubelet kubectl
# dnf install -y kubelet-1.36.2-150500.2.1 kubectl-1.36.2-150500.2.1
# systemctl daemon-reload && systemctl restart kubelet
# dnf versionlock add kubeadm kubelet kubectl
$ kubectl uncordon k8s-wl-01
wl-02 でも同じ手順を繰り返します。2 台の Workload Node を 1 台ずつ処理すれば、常にどちらか一方でワークロードが動き続けます。すべて終えたら k8s-ops で全ノードのバージョンを確認します。
実行コマンド(k8s-ops・developer):
$ kubectl get nodes実行結果:
NAME        STATUS   ROLES           AGE   VERSION
k8s-cp-01   Ready    control-plane   33m   v1.36.2
k8s-cp-02   Ready    control-plane   5h    v1.36.2
k8s-cp-03   Ready    control-plane   5h    v1.36.2
k8s-wl-01   Ready    <none>          5h    v1.36.2
k8s-wl-02   Ready    <none>          5h    v1.36.2
5 ノードすべてが v1.36.2 になりました。クラスタ全体のローリングアップグレードが完了です。
なお、ここまで drain / uncordon / get nodes を実行してきた作業端末 k8s-ops の kubectl 自体は v1.35.6 のままです。作業端末の kubectl は各ノードの kubelet/kubectl とは別に導入されており(本巻では rpm 管理外)、今回のアップグレード対象には含めていません。冒頭のスキュー規則のとおり kubectl は apiserver の ±1 マイナー以内なら動作するため、v1.35.6 の kubectl でも v1.36.2 のクラスタを問題なく操作できます(kubectl version を実行すると Client Version: v1.35.6 / Server Version: v1.36.2 の混在が見えますが、正常です)。作業端末側もバージョンを揃えたい場合は、任意のタイミングで v1.36.2 のバイナリへ入れ替えてください。
1 点、本番向けの注意です。fanclub-db(PostgreSQL)は第4回で入れた local-path のボリュームを使っており、そのボリュームは Pod が載ったノードのローカルディスクに固定されます。そのため db が載っている側の Workload Node を drain すると、db はいったん停止し、そのノードが uncordon されるまで戻れません(他ノードへは移せない)。単一レプリカ + local-path の DB はアップグレード中に短い停止が生じる、という点は覚えておいてください。第12回で分散ストレージ Longhorn に移すと、この制約は解消します。
証明書を更新する(certs check-expiration / renew)
アップグレードと並んで、Control Plane の運用で欠かせないのが証明書の更新です。kubeadm が発行するクラスタ証明書(apiserver・etcd・kubelet client など)は既定で 1 年で失効します。失効すると API Server が起動できなくなり、クラスタが操作不能になります。まず現在の期限を確認します。cp-01 で実行します。
実行コマンド(k8s-cp-01・root):
# kubeadm certs check-expiration実行結果(抜粋):
CERTIFICATE                EXPIRES                  RESIDUAL TIME   CERTIFICATE AUTHORITY   EXTERNALLY MANAGED
admin.conf                 Jul 12, 2027 03:47 UTC   364d            ca                      no
apiserver                  Jul 12, 2027 03:47 UTC   364d            ca                      no
apiserver-etcd-client      Jul 12, 2027 03:47 UTC   364d            etcd-ca                 no
etcd-server                Jul 12, 2027 03:47 UTC   364d            etcd-ca                 no

CERTIFICATE AUTHORITY   EXPIRES                  RESIDUAL TIME   EXTERNALLY MANAGED
ca                      Jul 08, 2036 22:59 UTC   9y              no
各証明書の残存期間(RESIDUAL TIME)が一覧で出ます。ここでは 364d(約 1 年)と表示されています。これは、先ほどの kubeadm upgrade apply が証明書も自動更新するためで、アップグレード直後は 1 年に戻っています。証明書の一番上(CA=認証局)は 9 年と長寿命で、更新対象は主にその下の各証明書(leaf)です。
アップグレードとは別に、証明書だけを更新したいこともあります(「今回はバージョンは上げないが、証明書の期限が近い」ケースなど)。その場合は kubeadm certs renew all で全証明書をまとめて更新します。
実行コマンド(k8s-cp-01・root):
# kubeadm certs renew all実行結果(末尾):
certificate for serving the Kubernetes API renewed
certificate the apiserver uses to access etcd renewed
certificate for the API server to connect to kubelet renewed
certificate embedded in the kubeconfig file for the controller manager to use renewed
certificate for liveness probes to healthcheck etcd renewed
certificate for etcd nodes to communicate with each other renewed
certificate for serving etcd renewed
certificate for the front proxy client renewed
certificate embedded in the kubeconfig file for the scheduler manager to use renewed
certificate embedded in the kubeconfig file for the super-admin renewed

Done renewing certificates. You must restart the kube-apiserver, kube-controller-manager, kube-scheduler and etcd, so that they can use the new certificates.末尾のメッセージが重要です。証明書を更新しただけでは、稼働中のコンポーネントは古い証明書を使い続けます。新しい証明書を読み込ませるには、メッセージにあるとおり apiserver・controller-manager・scheduler・etcd の 4 つの Static Pod を再起動する必要があります(renew all は etcd 用の証明書も更新するため、etcd も忘れず再起動します)。再起動は、これら 4 つの manifest を /etc/kubernetes/manifests/ の外へ一度退避し、少し待ってから戻すのが簡単です。ここで 退避してすぐ戻すと、kubelet が変化に気づかず Pod を作り直さないことがあるため、間に十数秒の待ちを入れます(kubelet が manifest の消失を検知して Pod を止めるのを待ってから戻す)。3 メンバー HA なので、cp-01 の etcd を一時停止しても残り 2 台が quorum を保ち、クラスタは動き続けます。
実行コマンド(k8s-cp-01・root):
# mkdir -p /etc/kubernetes/tmp-restart
# mv /etc/kubernetes/manifests/etcd.yaml \
     /etc/kubernetes/manifests/kube-apiserver.yaml \
     /etc/kubernetes/manifests/kube-controller-manager.yaml \
     /etc/kubernetes/manifests/kube-scheduler.yaml \
     /etc/kubernetes/tmp-restart/
# sleep 20
# mv /etc/kubernetes/tmp-restart/*.yaml /etc/kubernetes/manifests/
# rmdir /etc/kubernetes/tmp-restart
最後の rmdir は、退避に使った空ディレクトリを片付けているだけです(残しておいても実害はありません)。数十秒待つと apiserver 等が新しい証明書で起動し直します。check-expiration をもう一度実行すると、期限が更新(本日から約 1 年後)されていることを確認できます。この証明書更新は各 Control Plane Node で必要です(cp-02・cp-03 でも同様に renew all → 再起動を行います)。なお kubelet 自身のサーバ証明書は、既定の自動ローテート(rotateCertificates)で更新されるため、手動更新の対象は主にコントロールプレーンの証明書です。
また、AlmaLinux ではパッケージのバージョン固定に dnf versionlock を使いました。Kubernetes 公式ドキュメントでは Debian/Ubuntu 系の apt-mark hold / unhold が例示されますが、本巻(AlmaLinux)では読み替えて dnf versionlock を使う点に注意してください。
ミニトラブルシュート:Pending Pod を診断する
アップグレードの後にありがちな不具合が「uncordon し忘れ」です。ノードを drain(=cordon)したまま uncordon を忘れると、そのノードには新しい Pod がスケジュールされません。ここでは、両方の Workload Node を cordon したまま Pod を作り、原因を kubectl describe の Events から突き止める練習をします。CKA のトラブルシュート(D5)の基本形「describe → Events を読む」を体で覚えます。まず「うっかり両方 cordon したまま」の状態を作ります。
実行コマンド(k8s-ops・developer):
$ kubectl cordon k8s-wl-01 k8s-wl-02
$ kubectl run test-pending --image=nginx:1.27-alpine
$ kubectl get pod test-pending
実行結果:
NAME           READY   STATUS    RESTARTS   AGE
test-pending   0/1     Pending   0          8s
Pod が Pending のまま動きません。原因を describe の Events で確認します。
実行コマンド(k8s-ops・developer):
$ kubectl describe pod test-pending実行結果(Events 抜粋):
Events:
  Type     Reason            Age   From               Message
  ----     ------            ----  ----               -------
  Warning  FailedScheduling  9s    default-scheduler  0/5 nodes are available: 2 node(s) were unschedulable, 3 node(s) had untolerated taint(s). no new claims to deallocate, preemption: 0/5 nodes are available: 5 Preemption is not helpful for scheduling.
Events が原因をはっきり教えてくれます。0/5 nodes are available=5 ノードのどこにも置けない。内訳は 2 node(s) were unschedulable(=cordon した wl-01・wl-02)と 3 node(s) had untolerated taint(s)(=taint のある cp-01〜03)です。つまり「Workload Node を 2 台とも cordon してしまったので置き場所がない」と分かります。uncordon で解消します。
実行コマンド(k8s-ops・developer):
$ kubectl uncordon k8s-wl-01 k8s-wl-02
$ kubectl get pod test-pending -o wide
実行結果:
NAME           READY   STATUS    RESTARTS   AGE   IP               NODE
test-pending   1/1     Running   0          32s   10.244.215.207   k8s-wl-01
uncordon した途端に wl-01 へスケジュールされ、Running になりました。「Pending を見たら、まず describe の Events を読む」――これがトラブルシュートの第一歩です。確認が済んだら kubectl delete pod test-pending で片付けておきます。
やってみよう
upgrade plan を読む
cp-01 で kubeadm の固定解除 → リポジトリ張り替え → 新 kubeadm 導入 → kubeadm upgrade plan を実行し、現行版(Cluster version)と目標版(Target version)、そして「apply の後に手動で上げる必要があるもの=各ノードの kubelet」を読み取ってください。
1 ノードを通しでアップグレードする
cp-01 を kubeadm upgrade apply v1.36.2 で上げ、次に wl-01 を「kubeadm upgrade node → drain → kubelet/kubectl 入れ替え → uncordon」の順で 1 台通してアップグレードしてください。kubectl get nodes で cp-01 と wl-01 が v1.36.2、残りが v1.35.6 の混在状態を確認できれば成功です。
証明書の期限を確認して更新する
cp-01 で kubeadm certs check-expiration により全証明書の残存期間を読み、kubeadm certs renew all で更新 → etcd を含む 4 つの control-plane Static Pod を再起動(manifest を退避 → 十数秒待つ → 戻す)→ もう一度 check-expiration で期限が伸びたことを確認してください。退避後すぐ戻すと再起動されない点、CA と各証明書(leaf)で寿命が違う点にも注目してください。
Pending Pod を診断する
wl を 2 台とも cordon した状態で Pod を作り、kubectl describe pod の Events で FailedScheduling の原因(unschedulable / untolerated taint)を読み取り、uncordon で復旧させてください。
まとめ
本回では、kubeadm クラスタを v1.35.6 から v1.36.2 へローリングアップグレードしました。鍵はバージョンスキューに基づく順序(Control Plane 先・Workload Node 後)、apply(1 台目)と upgrade node(それ以外)の使い分け、マイナーをまたぐ際のリポジトリ張り替え、dnf versionlock による固定・解除、各ノードでの kubelet/kubectl 入れ替え、そして drain / uncordon の連携でした。あわせて kubeadm certs check-expiration / renew all による証明書更新(更新後の再起動が必要)と、Pending Pod を describe の Events から診断する型を身につけました。クラスタは v1.36 になり、「止めずに育てる」運用の第一歩を踏み出しました。
理解度チェック(○×形式・全 9 問)
次の各文が正しいか(○)誤りか(×)を判断してください。下の「解答と解説」を開くと答え合わせができます。
- Workload Node を Control Plane より先にアップグレードしてよい。
- 2 台目以降の Control Plane は
kubeadm upgrade applyを使う。 - kubelet は kube-apiserver より新しいバージョンでもよい。
- マイナーアップグレードでは、リポジトリ定義を新しいマイナー(v1.36)へ張り替える必要がある。
- AlmaLinux では
apt-mark holdでパッケージのバージョンを固定する。 - kubeadm が発行するクラスタ証明書は既定で 1 年で失効する。
kubeadm upgrade applyは証明書も自動更新する。kubeadm certs renew allの後、コンポーネントを再起動しなくても新しい証明書が使われる。- Pending Pod の原因調査は
kubectl describe podの Events を読むのが基本である。
解答と解説
1=×(Control Plane を先に上げる。逆順はスキュー違反)/2=×(2 台目以降と Workload Node は kubeadm upgrade node。apply は 1 台目だけ)/3=×(kubelet ≤ apiserver。新しくしてはいけない)/4=○(マイナーをまたぐ場合は repo 張り替えが必須)/5=×(AlmaLinux は dnf versionlock。apt-mark は Debian/Ubuntu 系)/6=○(既定 1 年)/7=○(apply は証明書も更新する)/8=×(更新後は apiserver 等の再起動が必要)/9=○(describe の Events が第一手)
次回予告
次回・第7回では、Pod スケジューリングに踏み込みます。nodeSelector / nodeAffinity / podAffinity / podAntiAffinity と taint / toleration を使い、「どの Pod をどのノードに載せるか」を意図どおりに制御する技術を学びます。あわせて第1巻で扱った D2(multi-container Pod・rollout/undo)を CKA 形式で再確認します。
