
新卒インフラエンジニア向け「Kubernetes 実践教科書 ② CKA クラスタ構築・運用編」(全16回)の第10回です。前回は Service と MetalLB で通信を「繋ぐ」側を扱いました。本回はその逆、通信を「絞る」側に踏み込みます。既定では Kubernetes の Pod 同士はすべて通信できるフラットなネットワークですが、本番では「必要な通信だけ許可し、あとは塞ぐ」ゼロトラストが求められます。それを実現するのが NetworkPolicy です。第1巻でも NetworkPolicy には触れましたが、本回は default-deny のよくある落とし穴(DNS の巻き添え遮断)を実機で体験し、さらに私たちの fanclub-api が chart の時点で既にゼロトラスト化されている——その本番設計を読み解きます。
操作は作業端末 k8s-ops(192.168.1.122)から kubectl で行います。プロンプトの $ は一般ユーザー developer、第4回で配布した admin.conf(cluster-admin)を使います。本回で作る YAML は developer のホーム配下の作業ディレクトリにまとめます(所有者は developer・sudo は使いません)。破壊をともなうハンズオンは、稼働中の fanclub を壊さないよう使い捨ての netpol-demo 名前空間で行い、fanclub の既存ポリシーは「読むだけ」で触りません。
実行コマンド(k8s-ops・developer):
$ mkdir -p ~/netpol && cd ~/netpol目次
今ここマップ(全 16 回中の現在地)
本シリーズは 6 部構成です。現在地は第3部「ネットワーク」の第10回です。
- 第1部 クラスタ構築(第1〜5回)
- 第2部 ワークロード管理(第6〜8回)
- 第3部 ネットワーク(第9〜11回)← 今ここ
- 第4部 ストレージ(第12回)
- 第5部 監視・運用(第13〜14回)
- 第6部 トラブルシュート(第15〜16回)
- Kubernetes v1.36.2
- kubectl v1.35.6(作業端末)
- CNI Calico v3.32.0
- busybox 1.37
- AlmaLinux 10.2
- NetworkPolicy の API (
networking.k8s.io/v1)は安定版で、マイナー番号が変わっても同じ - 確認日 2026-07-16
この回のゴール
本回を終えると、次のことができるようになります。到達できたかは記事末の「やってみよう」と「理解度チェック」で確認します。
- NetworkPolicy の Ingress/Egress ルールを詳細に設計できる
- default-deny + 必要許可のホワイトリスト型ポリシーを組める
- Calico のアーキテクチャと、Cilium(eBPF・L7)との違いを説明できる
- NetworkPolicy 起因の疎通不能を診断・解決できる
NetworkPolicy の基礎(おさらいと 3 つの要点)
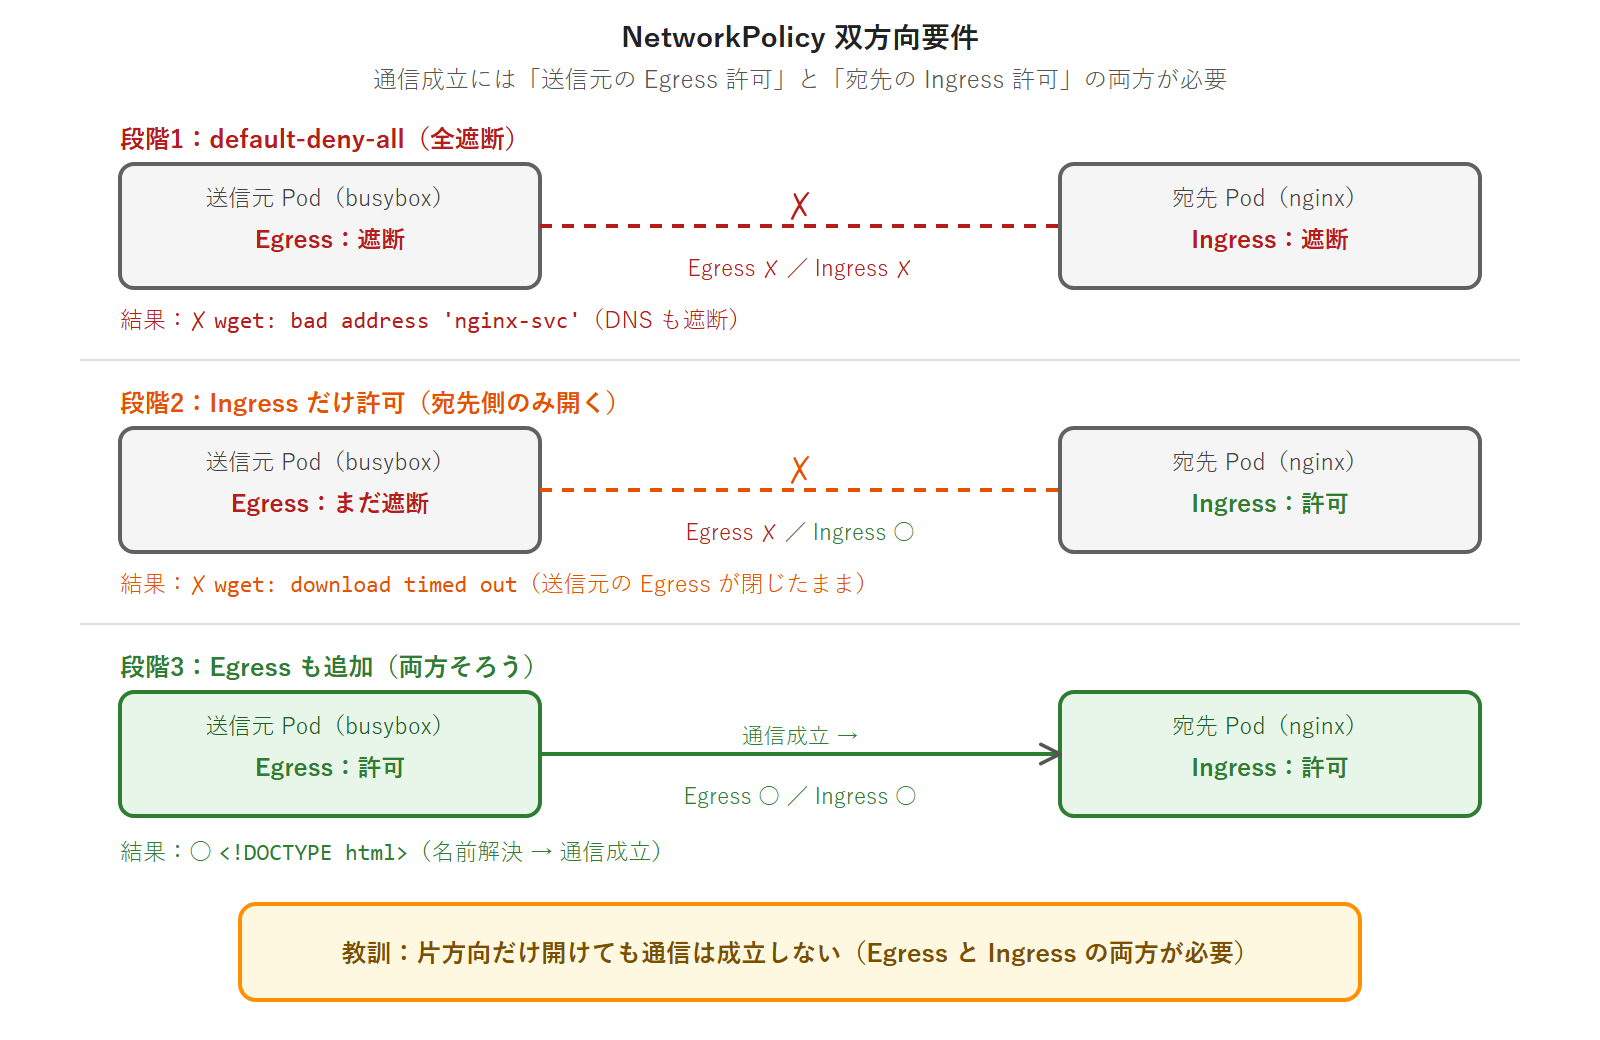
Kubernetes の Pod ネットワークは既定で「全許可」です。どの Pod からどの Pod へも自由に通信できます。ここに NetworkPolicy を 1 つでも適用すると、その Pod は「選択された方向は、明示的に許可した通信だけ」に切り替わります。これがゼロトラストの第一歩です。要点は次の 3 つです。
- Ingress(入ってくる)と Egress(出ていく)は独立:許可は方向ごとに別々に必要。Ingress を許可しても Egress は塞がったまま。
- 宛先・送信元の指定方法:
podSelector(ラベルで Pod を選ぶ)/namespaceSelector(名前空間で選ぶ)/ipBlock(CIDR で選ぶ)を組み合わせる。 - NetworkPolicy を実装するのは CNI:Kubernetes 本体はルールを保持するだけで、実際にパケットを通す/落とすのは CNI プラグイン。Calico は対応、Flannel 単体は非対応。本巻が Calico を選んだ理由の 1 つがこれです。
実際に、NetworkPolicy を強制している Calico が全ノードで動いていることを確認します。
実行コマンド(k8s-ops・developer):
$ kubectl get pods -n kube-system -l k8s-app=calico-node実行結果(5 ノード分):
NAME                READY   STATUS    RESTARTS   AGE
calico-node-cxgqc   1/1     Running   0          4d
calico-node-fp7dh   1/1     Running   0          4d
calico-node-g58t6   1/1     Running   0          4d
calico-node-nl58q   1/1     Running   0          4d
calico-node-xpcn6   1/1     Running   0          4d
各ノードに 1 つずつ calico-node が常駐し、これが各ノードで NetworkPolicy をカーネルのルールに落とし込んでいます。ここから、使い捨ての netpol-demo 名前空間で NetworkPolicy の挙動を手を動かして確かめます。
default-deny を敷いて DNS 遮断の落とし穴を体験する
実験用に netpol-demo 名前空間を作り、通信を試す busybox を 2 つ置きます。demo-server は 8080 番で待ち受ける簡易 HTTP サーバ、demo-client は疎通を試す側です(role ラベルで区別します)。busybox には nslookup/nc が入っているので、DNS と TCP 疎通の確認に使えます(fanclub の backend/frontend コンテナにはこれらが無いため、専用の busybox を使います)。
実行コマンド(k8s-ops・developer):
$ kubectl create namespace netpol-demo
$ kubectl run demo-server -n netpol-demo --image=busybox:1.37 --labels=app=demo,role=server --command -- httpd -f -p 8080 -h /etc
$ kubectl run demo-client -n netpol-demo --image=busybox:1.37 --labels=app=demo,role=client --command -- sleep 3600
2 つの Pod が Running になったら(数秒で立ち上がります。kubectl get pods -n netpol-demo で確認できます)、まずポリシーを一切適用していない状態で、client から DNS 解決と server への疎通ができることを確認します。server の Pod IP は変わるので、変数 SVR に入れて使います(この後のミニトラブルシュートでも同じ SVR を使うので、シェルを開き直したときや Pod を作り直したときは、この SVR=… の行を実行して取り直してください)。
実行コマンド(k8s-ops・developer):
$ SVR=$(kubectl get pod demo-server -n netpol-demo -o jsonpath='{.status.podIP}')
$ kubectl exec demo-client -n netpol-demo -- nslookup kubernetes.default.svc.cluster.local
$ kubectl exec demo-client -n netpol-demo -- nc -z -w2 $SVR 8080 && echo OPEN
実行結果(名前解決も 8080 疎通も成功):
Server:		10.96.0.10
Address:	10.96.0.10:53

Name:	kubernetes.default.svc.cluster.local
Address: 10.96.0.1
OPEN次に、netpol-demo の全 Pod に Ingress・Egress の両方を default-deny するポリシーを適用します。podSelector: {}(空セレクタ)は「名前空間の全 Pod」を意味します。次の内容を vi などのエディタで ~/netpol/default-deny.yaml として作成します(所有者は developer・sudo 不要。以降の kubectl apply は ~/netpol にいる前提の相対パスです)。
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: default-deny-all
  namespace: netpol-demo
spec:
  podSelector: {}
  policyTypes: [Ingress, Egress]
実行コマンド(k8s-ops・developer):
$ kubectl apply -f default-deny.yaml
$ kubectl exec demo-client -n netpol-demo -- nslookup kubernetes.default.svc.cluster.local
実行結果(応答まで数秒かかり、名前解決が失敗する):
;; connection timed out; no servers could be reachedここがよくある落とし穴です。Egress を default-deny すると、Pod は kube-system の CoreDNS(kube-dns)への 53 番にも出られなくなり、すべての名前解決が失敗します。本番でアプリが突然「Service 名で DB に繋がらない」と言い出したら、まず Egress ポリシーで DNS が巻き添えになっていないかを疑うのが定石です。対処は、CoreDNS への Egress(53/UDP・TCP)だけを明示的に開けることです。~/netpol/allow-dns.yaml を作成します(namespaceSelector で使う kubernetes.io/metadata.name ラベルは Kubernetes が全 Namespace に自動で付けるので、kube-system 側に手を加える必要はありません)。
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: allow-dns
  namespace: netpol-demo
spec:
  podSelector: {}
  policyTypes: [Egress]
  egress:
  - to:
    - namespaceSelector:
        matchLabels:
          kubernetes.io/metadata.name: kube-system
      podSelector:
        matchLabels:
          k8s-app: kube-dns
    ports:
    - {protocol: UDP, port: 53}
    - {protocol: TCP, port: 53}
実行コマンド(k8s-ops・developer):
$ kubectl apply -f allow-dns.yaml
$ kubectl exec demo-client -n netpol-demo -- nslookup kubernetes.default.svc.cluster.local
実行結果(名前解決が復活する):
Server:		10.96.0.10
Address:	10.96.0.10:53

Name:	kubernetes.default.svc.cluster.local
Address: 10.96.0.1
DNS は戻りましたが、default-deny は生きているので、server への 8080 疎通はまだ塞がったままです。次で「必要な通信だけ」を開けていきます。
必要な通信だけ許可する(ホワイトリスト設計)
default-deny を土台に、「role=client から role=server の 8080 番だけ」を許可します。通信を成立させるには、client 側の Egress 許可と server 側の Ingress 許可の両方が要ります(片方だけでは通りません)。~/netpol/allow-client-to-server.yaml を作成します。
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: allow-client-to-server
  namespace: netpol-demo
spec:
  podSelector:
    matchLabels:
      role: client
  policyTypes: [Egress]
  egress:
  - to:
    - podSelector:
        matchLabels:
          role: server
    ports:
    - {protocol: TCP, port: 8080}
---
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: allow-server-from-client
  namespace: netpol-demo
spec:
  podSelector:
    matchLabels:
      role: server
  policyTypes: [Ingress]
  ingress:
  - from:
    - podSelector:
        matchLabels:
          role: client
    ports:
    - {protocol: TCP, port: 8080}
適用し、「許可した 8080 は通る・許可していない 9999 は塞がる」を対比して確認します。
実行コマンド(k8s-ops・developer):
$ kubectl apply -f allow-client-to-server.yaml
$ kubectl exec demo-client -n netpol-demo -- nc -z -w2 $SVR 8080 && echo OPEN || echo BLOCKED
$ kubectl exec demo-client -n netpol-demo -- nc -z -w2 $SVR 9999 && echo OPEN || echo BLOCKED
実行結果(8080 は通り、9999 は塞がる):
OPEN
BLOCKED
これで「default-deny → DNS 例外 → 経路ごとの最小許可」というホワイトリスト設計の型が体得できました。この型こそ、次に読み解く fanclub の本番ポリシーそのものです。
fanclub の本番ポリシーを読み解く
ここで fanclub 名前空間を覗いてみます。fanclub-api は、第4回で Helm chart を入れた時点から既にゼロトラスト化されています。
実行コマンド(k8s-ops・developer):
$ kubectl get networkpolicy -n fanclub実行結果:
NAME                               POD-SELECTOR           AGE
allow-backend-from-frontend        app=fanclub-backend    4d
allow-db-from-backend              app=fanclub-db         4d
allow-dns                          <none>                 4d
allow-egress-backend-to-db         app=fanclub-backend    4d
allow-egress-batch-to-db           app=fanclub-batch      4d
allow-egress-frontend-to-backend   app=fanclub-frontend   4d
default-deny-all                   <none>                 4d
先ほど手で組んだ型が、そのまま本番設計になっています。読み解くとこうです。
- default-deny-all(全 Pod・Ingress+Egress):土台。まず全部塞ぐ。
- allow-dns(全 Pod・Egress 53):DNS の例外。先ほど体験した落とし穴が、chart 側で最初から手当てされている。
- frontend → backend → db の 3 層:
allow-egress-frontend-to-backend/allow-backend-from-frontend(8080)とallow-egress-backend-to-db/allow-db-from-backend(5432)。各層が「隣の 1 段」だけと話せる最小権限。 - allow-egress-batch-to-db:日次レポートの CronJob(
app=fanclub-batch)が DB へ出るための許可。バッチ経路も塞がないよう用意されている。
1 本の中身を describe で見てみます。
実行コマンド(k8s-ops・developer):
$ kubectl describe networkpolicy allow-egress-backend-to-db -n fanclub実行結果(抜粋):
Spec:
  PodSelector:     app=fanclub-backend
  Not affecting ingress traffic
  Allowing egress traffic:
    To Port: 5432/TCP
    To:
      PodSelector: app=fanclub-db
  Policy Types: Egress
「backend は db の 5432 へ出る Egress のみ・それ以外の外向き通信は無し」という最小権限がそのまま読み取れます。なおfrontend への外部からの入口(Ingress)は、この時点ではまだありません——現在の外部公開は port-forward だけです。第11回で --set gateway.enabled=true にすると、chart が allow-frontend-from-gateway(Traefik から frontend への Ingress 許可)を追加し、https://fanclub.local の外部公開が default-deny の下でも成立します。
Calico と Cilium の比較(CNI 選定の判断材料)
NetworkPolicy を実装するのは CNI なので、「どの CNI を選ぶか」は運用設計の一部です。CKA でも D3 に「適切な CNI プラグインを選ぶ」が含まれます。代表的な 2 つを押さえます。
- Calico:iptables/eBPF の両データプレーンを持つ成熟した CNI。標準の NetworkPolicy(L3/L4)に準拠し、実績も豊富。本巻で採用。
- Cilium:eBPF ネイティブで、標準の NetworkPolicy に加え L7(HTTP のメソッド/パス単位)の制御や、Hubble による通信の可視化、Pod 間 mTLS などに対応する。
CKA で問われるのはここまで——「NetworkPolicy を強制できる CNI を、要件に応じて選べる」ことです。標準的な L3/L4 のホワイトリストで足りるなら Calico で十分、L7 制御や可視化・mTLS まで要るなら Cilium、という選ぶ判断ができれば問題ありません。Cilium の eBPF 内部や L7 ポリシーの書き方、Hubble、mTLS の詳細は第3巻(CKS)の領域なので、本回では踏み込みません。
ミニトラブルシュート:NetworkPolicy 起因の遮断を切り分ける
NetworkPolicy のトラブルで多いのが「セレクタのラベル指定を間違えて、通したい通信が通らない」パターンです。netpol-demo でわざと再現します。~/netpol/allow-client-to-server.yaml の allow-server-from-client 側の from にある role: client を、存在しない role: frontend に書き換えて、適用し直します。
実行コマンド(k8s-ops・developer):
$ kubectl apply -f allow-client-to-server.yaml
$ kubectl exec demo-client -n netpol-demo -- nc -z -w2 $SVR 8080 && echo OPEN || echo BLOCKED
実行結果(通っていたはずの 8080 が塞がる):
BLOCKED切り分けの手順です。まず DNS を疑い(Egress deny の常連なので)、DNS が生きているなら次に該当ポリシーの from/to のセレクタと Pod のラベルの一致を読みます。describe で「誰からを許可しているか」を確認します。
実行コマンド(k8s-ops・developer):
$ kubectl describe networkpolicy allow-server-from-client -n netpol-demo実行結果(抜粋・許可元が role=frontend になっている):
  Allowing ingress traffic:
    To Port: 8080/TCP
    From:
      PodSelector: role=frontend
  Policy Types: Ingress
client のラベルは role=client なのに、許可元が role=frontend =一致していないのが原因だとわかります。from を role: client に戻して適用し直せば復活します。
実行コマンド(k8s-ops・developer):
$ kubectl apply -f allow-client-to-server.yaml
$ kubectl exec demo-client -n netpol-demo -- nc -z -w2 $SVR 8080 && echo OPEN || echo BLOCKED
実行結果(復活):
OPEN「看板(Service/Policy)はあるのに通らない」ときは、EndpointSlice の空(第9回)と NetworkPolicy のセレクタ不一致の 2 つを疑う——これがネットワーク切り分けの型です。fanclub 本体で同じ切り分けを行う演習は、第16回のトラブルシュートで扱います。
実験に使った使い捨て名前空間は、まるごと削除して後始末します(fanclub の 7 本には影響しません)。
実行コマンド(k8s-ops・developer):
$ kubectl delete namespace netpol-demoやってみよう
以下はすべて使い捨ての netpol-demo で手を動かす演習です(fanclub は読むだけ)。本文のコマンドを実行済みなら、状態に応じて作り直し・削除で前提をそろえてから取り組んでください。
default-deny で DNS が巻き添えになることを確認する
netpol-demo に busybox を置き、default-deny-all(Ingress+Egress)を適用してから nslookup を実行し、connection timed out; no servers could be reached で名前解決が失敗することを確認してください。
CoreDNS への Egress を開けて名前解決を復活させる
allow-dns(kube-system の k8s-app=kube-dns への 53/UDP・TCP)を追加し、nslookup が再び解決できることを確認してください。
client → server の最小許可を組む
role=client の Egress と role=server の Ingress を両方書いて 8080 を許可し、nc -z で 8080 が通り・許可していない別ポートが塞がることを対比して確認してください。確認できたら kubectl delete namespace netpol-demo で後始末します。
まとめ
本回では NetworkPolicy によるゼロトラスト設計を掘り下げました。要点は、①NetworkPolicy を適用した Pod は「選択した方向は明示許可のみ」に切り替わり、Ingress と Egress は独立、②実装するのは CNI(Calico は対応・Flannel 単体は非対応)、③Egress を default-deny すると DNS が巻き添えで塞がるので CoreDNS への 53 番を例外で開ける、④default-deny → DNS 例外 → 経路ごとの最小許可という型は、そのまま fanclub の chart 同梱ポリシー(7 本)の本番設計になっている、⑤CNI 選定では Calico と Cilium の違い(L7・可視化・mTLS)を判断材料にできる、でした。
理解度チェック(○×形式・全 9 問)
次の各文が正しいか(○)誤りか(×)を判断してください。下の「解答と解説」を開くと答え合わせができます。
- NetworkPolicy を 1 つも適用していない Pod は、すべての通信が許可されている。
- NetworkPolicy を実装するのは kube-proxy である。
- Egress を default-deny すると、CoreDNS への 53 番も塞がり名前解決が失敗する。
- Flannel 単体でも NetworkPolicy を強制できる。
- Ingress を許可すれば、Egress も自動的に許可される。
- Service の selector に一致する Pod が無いと EndpointSlice は空になる(第9回)が、NetworkPolicy のセレクタ不一致も疎通不能の原因になる。
- Cilium は L7(HTTP のメソッド/パス)単位のポリシーに対応する。
- fanclub は第10回で初めて default-deny を敷く。
- ヘッドレスではない ClusterIP Service 宛の通信は、NetworkPolicy とは無関係に必ず届く。
解答と解説
1=○(既定は全許可)/2=×(実装は CNI。kube-proxy は Service の転送)/3=○(DNS の巻き添え=定石の落とし穴)/4=×(Flannel 単体は非対応。Calico 等が要る)/5=×(Ingress と Egress は独立・別々に許可が要る)/6=○(EndpointSlice 空とセレクタ不一致の 2 つを疑う)/7=○(Cilium は L7 対応)/8=×(chart で第4回から導入済み)/9=×(default-deny 下では NetworkPolicy の許可が無ければ届かない)
次回予告
次回・第11回は、第4回以来 port-forward で我慢していた外部公開を、いよいよブラウザの https://fanclub.local として復活させます。Gateway API(GatewayClass/Gateway/HTTPRoute)・Traefik・cert-manager・CoreDNS を組み合わせ、第9回で入れた MetalLB が Traefik に外部 IP を払い出す——第2巻ネットワークの総仕上げです。
