
新卒インフラエンジニア向け「Kubernetes 実践教科書 ② CKA クラスタ構築・運用編」(全16回)の第15回です。ここまでの 14 回で、クラスタは HA で組まれ、アプリが載り、監視も GitOps もバックアップも揃いました。本回からは第6部「トラブルシュート」——壊れたクラスタを自力で直す実技に入ります。CKA では D5(Troubleshooting)が配点の 30% を占める最重要ドメインで、ここからの 2 回はその集中訓練です。本回は Control Plane 側の 4 大障害——Static Pod(API Server)・etcd・kubelet・kubeconfig——を、「わざと壊す → 自力で診断する → 直す」の型で反復します。
本回は操作するホストが 2 種類あります。作業端末 k8s-ops(192.168.1.122)から kubectl を $(developer)で、Control Plane Node(k8s-cp-01=192.168.1.125 等)や Workload Node へ SSH して #(root)で、と使い分けます。ノードでは SSH 後に sudo -i で root になってください——ログインシェルになるので /etc/profile.d/proxy.sh のプロキシ設定が読み込まれ、後述の外部ダウンロード(crictl)も whitelist プロキシ経由で通ります。各コマンドの前にどちらで実行するかを明記します。本回のシナリオはすべて破壊操作です。必ず本回開始時点のスナップショットを取り、そこへ戻せる状態で実施してください(各シナリオは独立して試せるよう、1 つ壊して直したら次へ進みます)。
目次
今ここマップ(全 16 回中の現在地)
本シリーズは 6 部構成です。現在地は第6部「トラブルシュート」の第15回です。
- 第1部 クラスタ構築(第1〜5回)
- 第2部 ワークロード管理(第6〜8回)
- 第3部 ネットワーク(第9〜11回)
- 第4部 ストレージ(第12回)
- 第5部 監視・運用(第13〜14回)
- 第6部 トラブルシュート(第15〜16回)← 今ここ
この回のゴール
本回を終えると、次のことができるようになります。到達できたかは記事末の「やってみよう」と「理解度チェック」で確認します。
- Control Plane コンポーネントの障害を、切り分けの型に沿って診断・復旧できる
- Static Pod(
/etc/kubernetes/manifests/)の破損をcrictlで診断して修正できる etcdutl snapshot restore(第5回の復元方式・標準の/var/lib/etcdへ復元)を自力で実施できるjournalctl -u kubeletで kubelet の障害を読み取り、復旧できる- kubeconfig の
server誤りを、クラスタ障害と切り分けて直せる
トラブルシュートの型と、crictl の下ごしらえ
個々の障害に入る前に、切り分けの型を決めておきます。慌てて手を動かすのではなく、上から順に見ていくのが CKA でも本番でも効きます。
kubectl get nodes/kubectl get pods -Aでどこが異常かの当たりをつけるkubectl describeの Events とkubectl logsで症状を読む- ノードに入って
journalctl -u kubelet//etc/kubernetes/manifests///etc/kubernetes/*.confを見る - kubectl 自体が効かないときは、ノードで
crictl psを使い containerd 越しにコンテナを直接見る
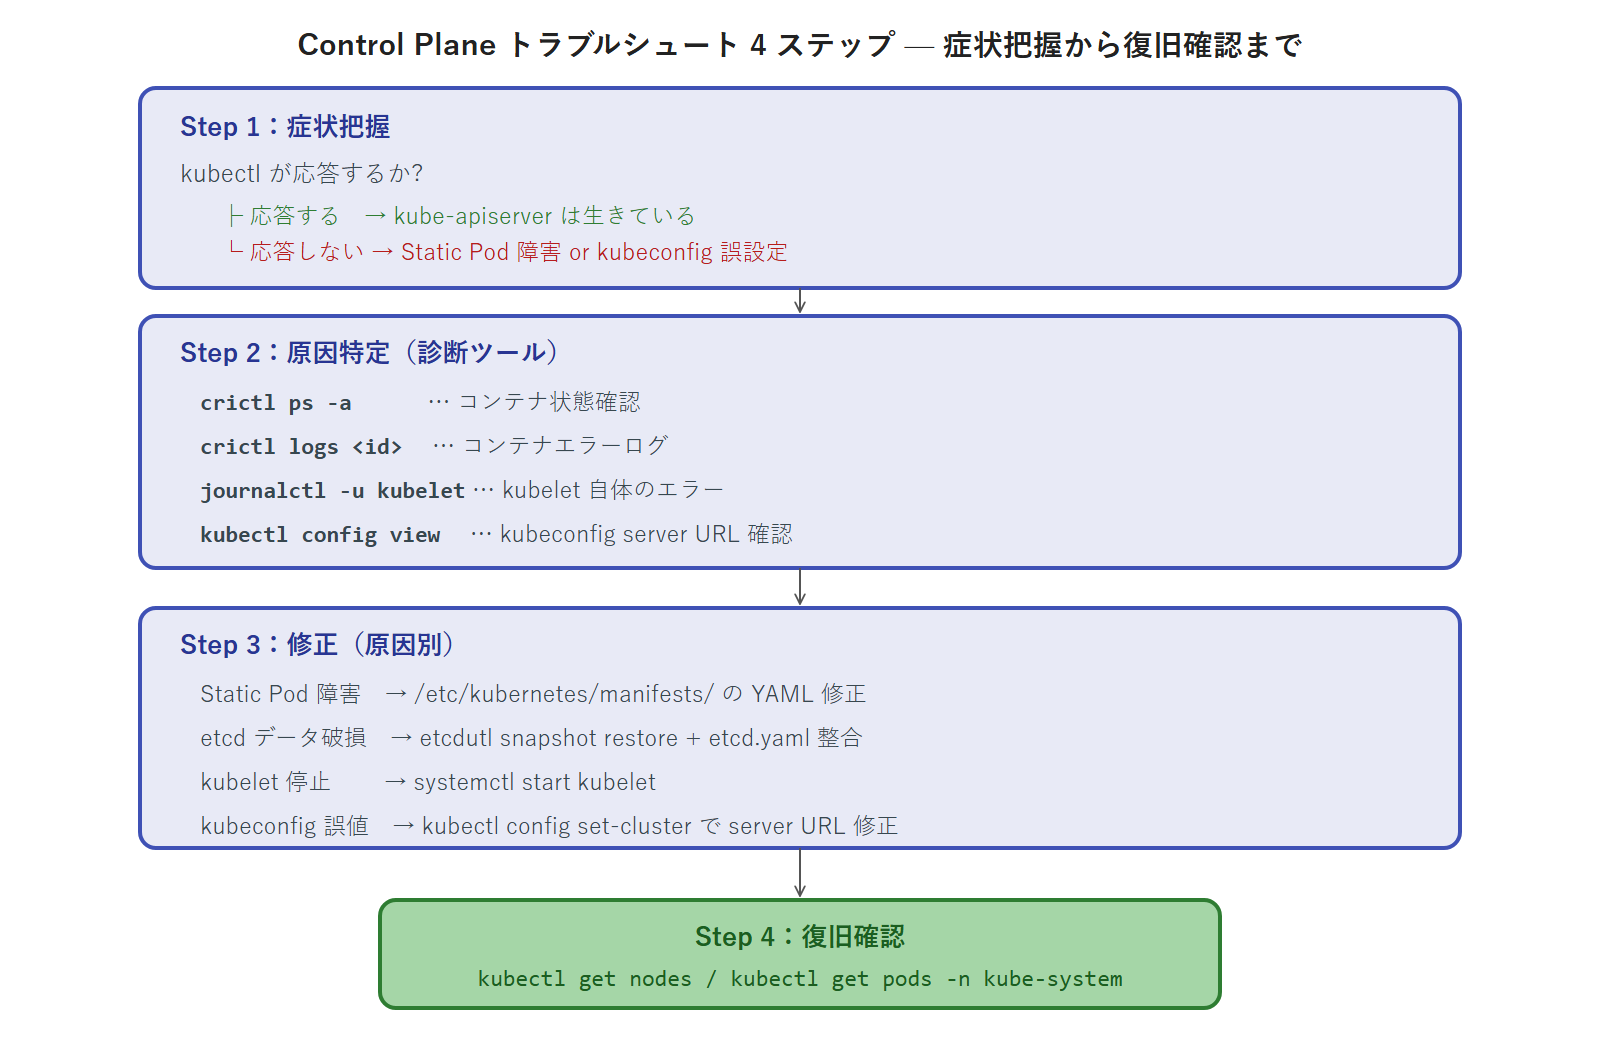
この 4 番目に crictl が要ります。API Server が落ちると kubectl はエラーになりますが、コンテナ自体は各ノードの containerd が動かしているので、crictl を使えば API Server 抜きでコンテナの状態やログを見られます。ところが本ラボの Control Plane Node には crictl が入っていません(CKA 試験環境には標準で在ります)。演習の前に、3 台の Control Plane Node すべてに導入します。バイナリは GitHub のリリースから取得します(配信元は第14回の argocd/velero と同じく whitelist 済み・sudo -i の root ログインシェルならプロキシ経由で通ります)。まず cp-01 で実施します。
実行コマンド(k8s-cp-01・root):
# dnf install -y tar
# curl -sSL -o /tmp/crictl.tar.gz https://github.com/kubernetes-sigs/cri-tools/releases/download/v1.35.0/crictl-v1.35.0-linux-amd64.tar.gz
# tar xzf /tmp/crictl.tar.gz -C /usr/bin
# cat > /etc/crictl.yaml <<'EOF'
runtime-endpoint: unix:///run/containerd/containerd.sock
image-endpoint: unix:///run/containerd/containerd.sock
timeout: 10
EOF
配置先を /usr/local/bin ではなく /usr/bin にしているのは、第5回で etcdctl を置いたときと同じ理由です——本環境では root(sudo)の secure_path に /usr/local/bin が含まれず、そこへ置くと # で crictl が見つかりません。/etc/crictl.yaml で containerd のソケットを指しておくと、毎回 --runtime-endpoint を付けずに済みます。動作を確認します。
実行コマンド(k8s-cp-01・root):
# crictl ps | head -5実行結果(稼働中コンテナが並べば OK。containerd に繋がっている証拠):
CONTAINER      IMAGE          CREATED       STATE     NAME             ...   POD
576ca0b297dce  99cea31eb93c2  about ...     Running   speaker          ...   metallb-speaker-...
2750f2bc3bad5  38667dd9be96c  about ...     Running   coredns          ...   coredns-...
...
同じ手順を cp-02・cp-03 でも実施してください(dnf install tar・ダウンロード・展開・/etc/crictl.yaml 作成)。3 台とも crictl が使える状態にしておきます。これで下ごしらえは完了です。1 つずつ壊していきます。
シナリオ1:Static Pod(API Server)が起動しない
Control Plane のコンポーネント(API Server・Scheduler・Controller Manager・etcd)は、Static Pod として動いています。Deployment ではなく、各ノードの kubelet が /etc/kubernetes/manifests/ に置かれた YAML を直接読んで起動するタイプです。ここが壊れると Control Plane が傾きます。API Server の manifest を壊して、症状と復旧を体験します。よくある事故はイメージタグの打ち間違いです。cp-01 の kube-apiserver.yaml の image を、存在しないタグに書き換えます。
実行コマンド(k8s-cp-01・root・障害の仕込み):
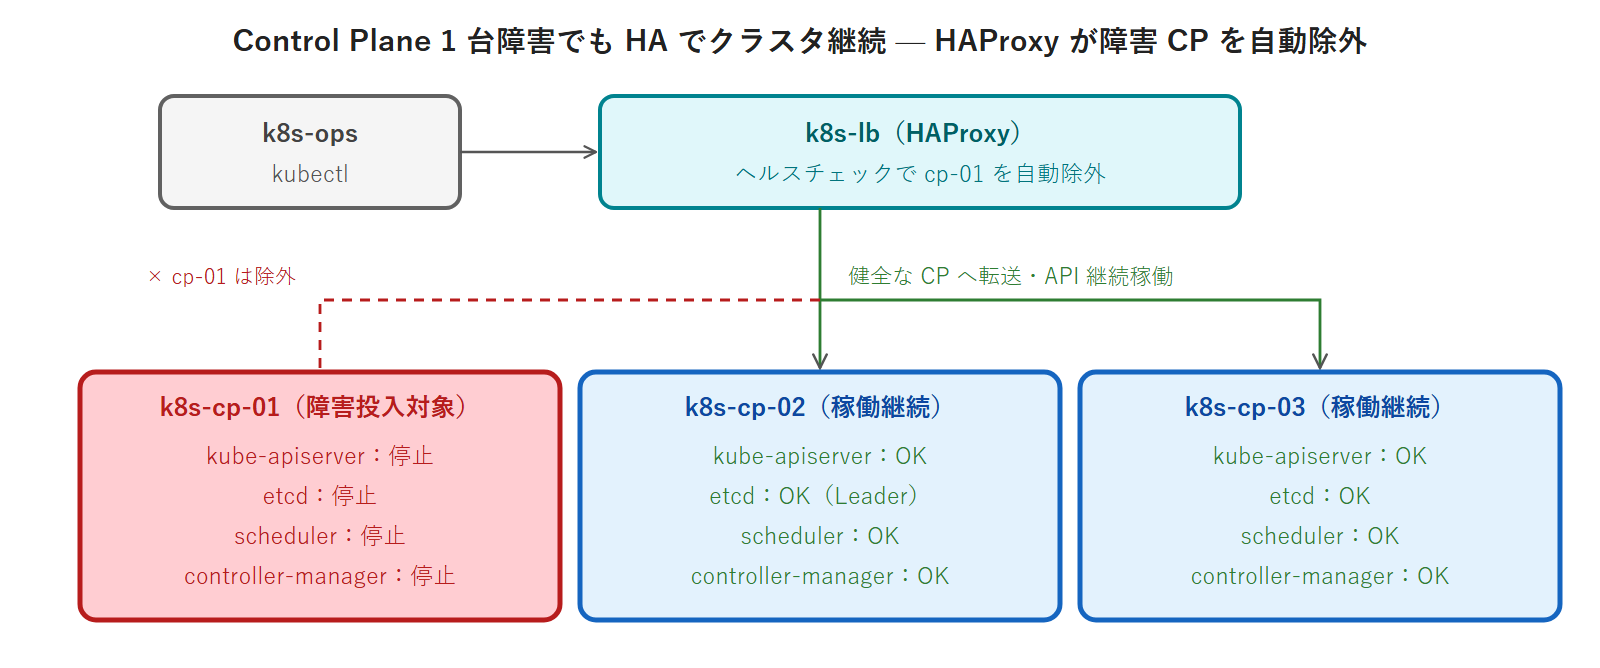
# sed -i 's#kube-apiserver:v1.36.2#kube-apiserver:v1.36.99#' /etc/kubernetes/manifests/kube-apiserver.yamlmanifest を書き換えると、kubelet がすぐに検知して cp-01 の API Server コンテナを作り直そうとします。ですが v1.36.99 は存在しないので、イメージの取得に失敗し、cp-01 の API Server が止まったままになります。ここで大事な観察があります——クラスタは HA で組んであるので、cp-01 の API Server が落ちても、cp-02・cp-03 の API Server が生きており、k8s-lb(HAProxy)が生きている方へ振り分けます。だから kubectl は(少し不安定になりつつも)まだ使えます。第3回で組んだ HA が効いている場面です。まずクラスタ全体の視点で、どこが異常かを見ます(ノードが NotReady に変わるまでには 40〜60 秒ほどかかります——node-controller が「kubelet から状態が来ない」と判断するまでの猶予時間(既定約 40 秒)に、検知の間が乗るためです。すぐに見ると、まだ Ready のことがあります)。
実行コマンド(k8s-ops・developer):
$ kubectl get nodes
$ kubectl get pods -n kube-system -o wide | grep apiserver
実行結果(cp-01 が NotReady。ただし下の Pod 一覧は当てにならない):
NAME        STATUS     ROLES           ...
k8s-cp-01   NotReady   control-plane   ...
k8s-cp-02   Ready      control-plane   ...
...
kube-apiserver-k8s-cp-01   1/1   Running   ...   k8s-cp-01   ← 止まっているのに Running のまま表示される
kube-apiserver-k8s-cp-02   1/1   Running   ...   k8s-cp-02
kube-apiserver-k8s-cp-03 1/1 Running ... k8s-cp-03ここが本回で一番の落とし穴です。kubectl get nodes は cp-01 が NotReady と正しく教えます(describe node を見ると Kubelet stopped posting node status と出ます)。ところが kubectl get pods の API Server は 1/1 Running のままで、異常が見えません。理由はこうです——Pod の状態を報告するのは、そのノードの kubeletです。cp-01 の API Server が落ちると、cp-01 の kubelet は状態を更新できなくなり、「最後に見た古い状態(Running)」が残ってしまうのです。つまり 落ちた当人のノードについては kubectl の Pod 状態を信用できません。真実はノードの中にあります。ここが crictl の出番です——API Server が落ちていても containerd は動いているので、コンテナの本当の状態を読めます。cp-01 に入って確認します。
実行コマンド(k8s-cp-01・root):
# crictl ps -a | grep apiserver
# crictl images | grep kube-apiserver
実行結果(apiserver コンテナは存在せず=起動できていない。v1.36.99 は images に無い):
(crictl ps -a に apiserver コンテナが 1 つも無い=起動できていない。get pods の Running とは食い違う)
registry.k8s.io/kube-apiserver   v1.35.6   ...
registry.k8s.io/kube-apiserver   v1.36.2   ...   (v1.36.99 は無い=実在しないタグを引こうとした)
「起動しようとしているイメージのタグが実在しない」と分かりました。決め手は manifest を直接読むことです。grep image: で、書き換わったタグを目で確かめます。
実行コマンド(k8s-cp-01・root):
# grep image: /etc/kubernetes/manifests/kube-apiserver.yaml実行結果:
image: registry.k8s.io/kube-apiserver:v1.36.99タグを正しい v1.36.2 に戻せば復旧します。Static Pod は kubelet が manifest を見張っているので、ファイルを直せば自動で作り直されます——kubectl apply は要りません。
実行コマンド(k8s-cp-01・root・復旧):
# sed -i 's#kube-apiserver:v1.36.99#kube-apiserver:v1.36.2#' /etc/kubernetes/manifests/kube-apiserver.yaml1 分ほど待って kubectl get nodes を見ると、cp-01 が Ready に戻ります——API Server が復活し、cp-01 の kubelet がノード状態をまた報告できるようになった証拠です(Pod 状態はもともと Running に見えていたので、復旧の判定は「ノードが Ready に戻ったか」で行うのが確実です)。Static Pod は「manifest が正、kubelet が追従する」——GitOps の ArgoCD が「Git が正」だったのと似た関係だと気づくと、頭に入りやすくなります。
crictl の使い分けを 1 つ押さえておきます。今回はイメージの取得で失敗したので、コンテナは一度も起動していません——だから crictl logs には何も出ず、診断は「crictl ps -a に居ない+crictl images にタグが無い+manifest のタグが変」で組み立てました。一方、image は正しいのに Pod が起動と停止を繰り返す(CrashLoopBackOff)場合は、コンテナが一度は起動しているので、crictl ps -a で Exited のコンテナ ID を拾い crictl logs <コンテナ ID> でクラッシュ理由(不正なフラグ・証明書パスの誤り等)を読めます。「起動前で落ちた(ImagePull)」か「起動後に落ちた(CrashLoop)」かで見る場所が変わる——これが API Server 抜きで診断するときの勘所です。
シナリオ2:etcd を壊して、バックアップから戻す
クラスタの全状態は etcd に入っています。ここが飛ぶとクラスタの記憶が失われます。第5回で etcdctl snapshot save と etcdutl snapshot restore を学びましたが、本回はインシデント対応として通します——「テスト用リソースを作り、バックアップを取り、誤って消し、バックアップから戻す」。手順は第5回で確立した復元方式(標準の /var/lib/etcd へ直接復元し、manifest は書き換えない)です。
まず目印になるリソースを作り、cp-01 でバックアップを取ります。etcdctl は稼働中の etcd に接続するので証明書オプションが要ります。etcd 3.6 では ETCDCTL_API=3 を付けません(API v3 が既定で、付けると unrecognized environment variable と警告されます)。
実行コマンド(k8s-ops・developer → cp-01・root):
$ kubectl create namespace restore-test
(ここから k8s-cp-01・root)
# mkdir -p /backup
# etcdctl --endpoints=https://192.168.1.125:2379 \
    --cacert=/etc/kubernetes/pki/etcd/ca.crt \
    --cert=/etc/kubernetes/pki/etcd/server.crt \
    --key=/etc/kubernetes/pki/etcd/server.key \
    snapshot save /backup/etcd-incident.db
# etcdutl snapshot status /backup/etcd-incident.db -w table
etcdutl snapshot status はファイルを読むだけなので証明書も endpoint も要りません(リビジョン・キー数・ハッシュが表として出ます)。ここでインシデント発生——restore-test 名前空間を誤って削除します。
実行コマンド(k8s-ops・developer・障害の仕込み):
$ kubectl delete namespace restore-testここから復旧です。第5回の復元手順は 3 段階——(1) 3 台の etcd と API Server を止める → (2) 3 台とも既存 data-dir を mv で退避し、標準の /var/lib/etcd へ復元 → (3) manifest を(無変更で)戻す。まず (1)、cp-01・cp-02・cp-03 の各ノードで、etcd と API Server の manifest を manifests/ の外へ退避します(ファイルを動かすと kubelet が Pod を止めます)。3 台とも API Server を止めるので、この間 kubectl は使えません——復旧作業は各ノードに SSH した #(root)だけで進み、(3) で manifest を戻すまで kubectl は戻りません。
実行コマンド(k8s-cp-01/02/03 それぞれ・root):
# mkdir -p /etc/kubernetes/manifests-stopped
# mv /etc/kubernetes/manifests/etcd.yaml /etc/kubernetes/manifests/kube-apiserver.yaml /etc/kubernetes/manifests-stopped/
次に (2)、同じスナップショットを 3 台に配り、各ノードで復元します。/backup/etcd-incident.db は root 所有で、VM 同士は直接 SSH できないため、手元のマシンを経由して配ります(第5回でスナップショットを配ったのと同じ 2 ホップ。kubectl を打つ k8s-ops ではなく、各 VM へ SSH できる手元のマシンから行います)。はじめに cp-01 で、developer が読める場所(/tmp)へ複製します。
実行コマンド(k8s-cp-01・root):
# cp /backup/etcd-incident.db /tmp/etcd-incident.db
# chown developer:developer /tmp/etcd-incident.db
手元のマシンへいったん取り寄せ、cp-02・cp-03 へ送ります。
実行コマンド(手元のマシン):
$ scp developer@192.168.1.125:/tmp/etcd-incident.db /tmp/etcd-incident.db
$ scp /tmp/etcd-incident.db developer@192.168.1.126:/tmp/etcd-incident.db
$ scp /tmp/etcd-incident.db developer@192.168.1.127:/tmp/etcd-incident.db
cp-02・cp-03 では、届いたファイルを /backup/(root)へ置きます(cp-01 以外は /backup がまだ無いので mkdir も要ります)。
実行コマンド(k8s-cp-02・k8s-cp-03 それぞれ・root):
# mkdir -p /backup
# cp /tmp/etcd-incident.db /backup/etcd-incident.db
これで 3 台とも /backup/etcd-incident.db が揃いました。ここから復元の本体です。作法が 2 つ——復元先は標準の /var/lib/etcd、そして既存 data-dir はrm ではなく mv で退避してから復元します(失敗しても戻せる安全策)。まず 3 台それぞれで退避します。
実行コマンド(k8s-cp-01/02/03 それぞれ・root):
# mv /var/lib/etcd /var/lib/etcd.bak退避して空いた /var/lib/etcd へ復元します。ノードごとに --name と --initial-advertise-peer-urls だけが変わり、--initial-cluster(3 メンバー全員)と --data-dir /var/lib/etcd は 3 台とも同じです。cp-01 の例を示します。
実行コマンド(k8s-cp-01・root):
# etcdutl snapshot restore /backup/etcd-incident.db \
    --name k8s-cp-01 \
    --initial-advertise-peer-urls https://192.168.1.125:2380 \
    --initial-cluster k8s-cp-01=https://192.168.1.125:2380,k8s-cp-02=https://192.168.1.126:2380,k8s-cp-03=https://192.168.1.127:2380 \
    --data-dir /var/lib/etcd
cp-02 では --name k8s-cp-02・--initial-advertise-peer-urls https://192.168.1.126:2380、cp-03 では --name k8s-cp-03・--initial-advertise-peer-urls https://192.168.1.127:2380 に変えて実行します。ここが本方式の勘所——復元先を標準の /var/lib/etcd にしたので、etcd.yaml はいっさい書き換えません(別ディレクトリへ復元すると manifest のパスも合わせる必要が生じ、さらに次の kubeadm upgrade で既定パスと食い違って壊れます。標準へ戻すのが結局いちばん安全です)。
最後に (3)、退避した etcd.yaml と kube-apiserver.yaml を中身は変えずそのまま戻します。kubelet が検知して etcd と API Server を起動し直し、標準の /var/lib/etcd の復元データを読みます。3 台すべてで戻すことが大切です。
実行コマンド(k8s-cp-01/02/03 それぞれ・root・復旧):
# mv /etc/kubernetes/manifests-stopped/etcd.yaml /etc/kubernetes/manifests-stopped/kube-apiserver.yaml /etc/kubernetes/manifests/1〜2 分待って、消したはずの restore-test 名前空間が戻っていることを確認します。
実行コマンド(k8s-ops・developer):
$ kubectl get namespace restore-test実行結果(復活していれば成功。AGE がスナップショット取得時点からの経過=元のリソースが戻った証拠):
NAME            STATUS   AGE
restore-test    Active   4m56s
etcd を戻すとクラスタ全体がスナップショット時点に巻き戻ります。だからこそ etcd snapshot は「クラスタ全体をまとめて戻せる最終手段」で、第14回の Velero(名前空間・アプリ単位)とは粒度が違う——両方を運用に備えておく、という第14回の話がここで生きてきます。うまく戻ったら、退避した /var/lib/etcd.bak は 3 台とも削除して構いません。
最後に、忘れやすい後始末があります。etcd を巻き戻すと、CNI(Calico)が握っているエンドポイント情報とクラスタの実状態がずれ、NetworkPolicy がどの Pod にも当たらなくなることがあります。ポリシーは kubectl get networkpolicy で見ると存在しているのに、実際には遮断されない——ゼロトラストで守っていたつもりが素通しになる、という危うい状態です。復元後は calico-node を入れ替えて、ポリシーを作り直させてください(入れ替えには数分かかります)。
実行コマンド(k8s-ops・developer・etcd 復元の後始末):
$ kubectl rollout restart daemonset calico-node -n kube-system「クラスタは戻ったが、CNI が古い状態を握ったままだった」——復旧作業でありがちな取りこぼしです。etcd の復元は「戻して終わり」ではなく、CNI の再起動までを 1 つの手順として覚えてください。次回(第16回)で NetworkPolicy を壊す演習を行いますが、ここで再起動しておかないと「壊したのに通ってしまう」ことになります。
シナリオ3:kubelet が止まってノードが NotReady
kubelet は各ノードで「Pod を実際に動かす」担当です。これが止まると、そのノードは NotReady になり、上の Pod が動かなくなります。Workload Node の一つ(k8s-wl-01)で kubelet を止めて、症状と復旧を見ます。
実行コマンド(k8s-wl-01・root・障害の仕込み):
# systemctl stop kubelet少し待って、作業端末からノードの状態を見ます。
実行コマンド(k8s-ops・developer):
$ kubectl get nodes実行結果(wl-01 が NotReady):
NAME        STATUS     ROLES           AGE   VERSION
k8s-cp-01   Ready      control-plane   ...   v1.36.2
...
k8s-wl-01   NotReady   <none>          ...   v1.36.2
k8s-wl-02   Ready      <none>          ...   v1.36.2
NotReady の原因を、ノードに入って kubelet のログで確かめます。kubectl logs は Pod のログ用で、kubelet 自身は systemd サービスなので journalctl -u kubelet で読みます。
実行コマンド(k8s-wl-01・root):
# systemctl status kubelet --no-pager
# journalctl -u kubelet --no-pager | tail -15
実行結果(停止していると分かる):
● kubelet.service - kubelet: The Kubernetes Node Agent
Active: inactive (dead) ...今回は単純に停止していただけなので、起動するだけで戻ります(本番では、ログに出た根本原因——証明書期限切れ・cgroup ドライバ不一致・設定ミスなど——を直してから起動します)。kubelet は kubeadm クラスタでは既定で自動起動が有効なので、enable は不要です(有効かどうかは systemctl is-enabled kubelet で確認できます。もし無効なら再起動時にまた止まるので systemctl enable kubelet も打ちます)。
実行コマンド(k8s-wl-01・root・復旧):
# systemctl start kubelet数十秒で kubectl get nodes の wl-01 が Ready に戻ります。kubelet ログの読み方(journalctl -u kubelet)は、ノード系トラブルの入口です。CKA でも「NotReady のノードを直す」は頻出です。
シナリオ4:kubectl が繋がらない(kubeconfig の誤り)
最後は紛らわしいやつです——kubectl が繋がらないとき、クラスタが壊れているのか、手元の設定が悪いのかを切り分けます。作業端末の kubeconfig(~/.kube/config)の接続先を、わざと誤ったポートに書き換えます。
実行コマンド(k8s-ops・developer・障害の仕込み):
$ cp ~/.kube/config ~/.kube/config.bak
$ sed -i 's#server: https://k8s-lb:6443#server: https://k8s-lb:6444#' ~/.kube/config
kubectl を打つと、繋がらなくなります。
実行コマンド(k8s-ops・developer):
$ kubectl get nodes実行結果(k8s-lb は 6444 で待ち受けていないので繋がらない。エラー文言は状況で少し変わります):
Unable to connect to the server: dial tcp 192.168.1.124:6444: connect: no route to hostここで慌てて Control Plane を触らないのがコツです。まずクラスタ側が生きているかを、kubeconfig を経由せずに確かめます。API Server の口(k8s-lb:6443)へ直接叩いてみます。
実行コマンド(k8s-ops・developer):
$ kubectl config view --minify | grep server
$ curl -sk https://k8s-lb:6443/healthz; echo
実行結果(設定は 6444、実際の口 6443 は ok で生きている):
    server: https://k8s-lb:6444
ok切り分けの答えが出ました——クラスタ(6443)は ok を返して生きており、悪いのは kubeconfig の server(6444)です。クラスタ障害ではなくクライアント設定の問題だと確定しました。設定を正しい 6443 へ戻します。
実行コマンド(k8s-ops・developer・復旧):
$ sed -i 's#server: https://k8s-lb:6444#server: https://k8s-lb:6443#' ~/.kube/config
$ kubectl get nodes
kubectl が戻ります。「繋がらない=クラスタ障害」と早合点しない——curl .../healthz でクラスタ側の生死を分離してから、原因を kubeconfig かクラスタかに切り分ける。この順番が、無用な操作で状況を悪化させないコツです。
やってみよう
すべて破壊操作です。必ず本回開始時点へ戻せるスナップショットを取ってから行ってください。1 つ壊して直したら、次へ進みます。
API Server の Static Pod を壊して直す
cp-01 の kube-apiserver.yaml の image を存在しないタグに変え、1 分ほど待って kubectl get nodes で cp-01 が NotReady になることを確認してください(切り替わりまで 40〜60 秒かかります)。このとき kubectl get pods の API Server が 1/1 Running のまま(=当てにならない)ことも見て、ノードで crictl ps -a(apiserver コンテナが無い)と grep image: で真因を特定し、タグを戻して kubectl get nodes が Ready に戻ることで復旧を確認してください。HA なので、この間も kubectl 自体は使えることも観察できます。
etcd をバックアップから戻す
restore-test 名前空間を作って etcdctl snapshot save、削除してから 第5回の復元手順(3 台停止 → mv 退避 → etcdutl snapshot restore --data-dir /var/lib/etcd → manifest を無変更で戻す)で復旧し、名前空間が戻ることを確認してください。ETCDCTL_API=3 は付けない点に注意。
NotReady ノード or kubeconfig 誤りを直す
wl-01 で systemctl stop kubelet → NotReady を journalctl -u kubelet で確認 → systemctl start kubelet で復旧(kubelet は既定で自動起動が有効なので enable は不要)。あるいは、~/.kube/config の server を誤値に変え、curl https://k8s-lb:6443/healthz でクラスタの生死を分離してから設定を戻してください。
まとめ
本回では Control Plane の 4 大障害を、仕込み→診断→復旧の型で通しました。①Static Pod(API Server)——/etc/kubernetes/manifests/ の YAML を直せば kubelet が追従する。API Server が落ちても crictl なら containerd 越しに診断でき、HA なら kubectl も生きている。②etcd——第5回の復元方式(標準の /var/lib/etcd へ復元・manifest 無変更・rm でなく mv)で全状態を巻き戻す。ETCDCTL_API=3 は 3.6 では付けない。③kubelet——journalctl -u kubelet で読み、NotReady を復旧する。④kubeconfig——curl .../healthz でクラスタの生死を分離し、クライアント設定の問題を切り分ける。共通するのは「上から順に切り分け、慌てて手を広げない」という型です。
理解度チェック(○×形式・全 9 問)
次の各文が正しいか(○)誤りか(×)を判断してください。下の「解答と解説」を開くと答え合わせができます。
- Static Pod は
/etc/kubernetes/manifests/の YAML を直せば、kubelet が自動で作り直す。 - API Server が落ちると、ノードでも
crictlでコンテナを見ることはできない。 - kubelet のログは
kubectl logsで読む。 - etcd 復元(第5回の方式)では、
/var/lib/etcdをrmせずmvで退避してから復元する。 - この方式では復元後に
etcd.yamlの--data-dirを書き換える必要がある。 - etcd 3.6 では
etcdctl snapshot saveにETCDCTL_API=3を付けるべきである。 - HA 構成なら、1 つの Control Plane の API Server が落ちても他経由で
kubectlを使える。 - kubeconfig の
server誤りは、クラスタ障害ではなくクライアント設定の問題である。 - Control Plane ノードの API Server が落ちると、そのノードの
kubectl get podsはすぐImagePullBackOffになり、異常が一目で分かる。
解答と解説
1=○/2=×(containerd は生きているので crictl で見られる。API Server 抜きの診断の要)/3=×(kubelet は systemd サービス。journalctl -u kubelet)/4=○(失敗しても戻せる安全策)/5=×(第5回の方式は標準の /var/lib/etcd へ復元し manifest は無変更。書き換えると次の upgrade で壊れる)/6=×(etcd 3.6 は API v3 が既定。付けると警告が出る)/7=○(第3回の HA が効く)/8=○/9=×(落ちた当人ノードは kubelet が状態を更新できず、Pod は古い Running のまま=当てにならない。信頼できるのは kubectl get nodes の NotReady と、ノードでの crictl。「繋がらないときは curl .../healthz でクラスタの生死を分離する」もあわせて型として押さえる)
次回予告
次回・第16回は第6部の後半、Workload Node + Network + App のトラブルシュートです。CrashLoopBackOff・Service の疎通不良・NetworkPolicy による遮断など、アプリ側の障害を診断・復旧し、第2巻を締めくくります(第2巻完走宣言)。
